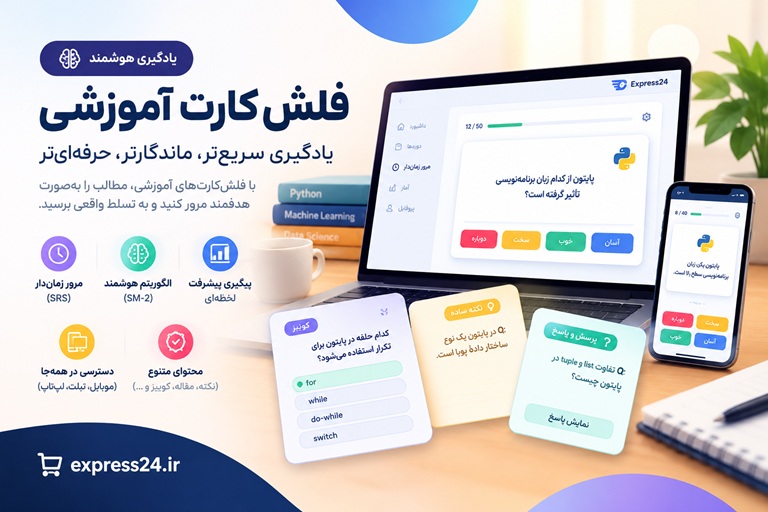
فلشکارتهای آموزشی تسریع بهینهسازی با یادگیری تقویتی: کنترل هوشمند تجزیه بندر ناکامل
تسریع بهینهسازی با یادگیری تقویتی: کنترل هوشمند تجزیه بندر ناکامل - دورهای برای متخصصین هوش مصنوعی و بهینهسازی دوره جامع: تسریع بهینهسازی با یادگیری تقویتی: کنترل هوشمند تجزیه بندر ناکامل آیا از ک...
🎓 دوره آموزشی جامع
📚 اطلاعات دوره
عنوان دوره: دوره تسریع بهینهسازی با یادگیری تقویتی: کنترل هوشمند تجزیه بندر ناکامل
موضوع کلی: هوش مصنوعی در بهینهسازی
موضوع میانی: یادگیری تقویتی برای بهینهسازی الگوریتمی
📋 سرفصلهای دوره
- 1. مقدمه بر بهینهسازی و تحقیق در عملیات
- 2. اهمیت هوش مصنوعی در حل مسائل پیچیده بهینهسازی
- 3. مروری بر برنامهریزی ریاضی: خطی و عدد صحیح
- 4. آشنایی با مسائل برنامهریزی خطی عدد صحیح مختلط (MILP)
- 5. چالشهای حل مسائل بهینهسازی در مقیاس بزرگ
- 6. مفهوم تجزیه در بهینهسازی: چرا مسائل را میشکنیم؟
- 7. معرفی الگوریتم تجزیه بندر (Benders Decomposition) کلاسیک
- 8. مبانی نظری تجزیه بندر: مسئله اصلی (Master Problem) و زیرمسئله (Subproblem)
- 9. برشهای بهینگی (Optimality Cuts) و برشهای امکانپذیری (Feasibility Cuts)
- 10. روند تکرارشونده در الگوریتم بندر: افزودن برشها
- 11. شرایط همگرایی و خاتمه در تجزیه بندر کلاسیک
- 12. محدودیتهای تجزیه بندر استاندارد: همگرایی کند و نوسانات
- 13. مقدمهای بر یادگیری تقویتی (Reinforcement Learning)
- 14. عناصر کلیدی یادگیری تقویتی: عامل، محیط، حالت، عمل، پاداش
- 15. فرآیندهای تصمیمگیری مارکوف (MDPs) به عنوان چارچوب رسمی
- 16. توابع ارزش (Value Functions) و توابع ارزش-عمل (Action-Value Functions)
- 17. سیاست (Policy): استراتژی تصمیمگیری عامل
- 18. یادگیری مبتنی بر مدل در مقابل یادگیری بدون مدل
- 19. الگوریتمهای مبتنی بر ارزش (Value-Based) در مقابل مبتنی بر سیاست (Policy-Based)
- 20. الگوریتمهای بازیگر-منتقد (Actor-Critic)
- 21. ایده اصلی مقاله: کنترل یک الگوریتم بهینهسازی با یادگیری تقویتی
- 22. مفهوم "ناکامل" (Inexactness) در الگوریتمهای بهینهسازی
- 23. معرفی تجزیه بندر ناکامل (Inexact Benders Decomposition)
- 24. مزایای ناکاملی: تسریع هر تکرار
- 25. معایب ناکاملی: برشهای ضعیفتر و افزایش تعداد تکرارها
- 26. تعادل کلیدی: میزان ناکاملی در هر مرحله
- 27. نقاط کنترلی در الگوریتم بندر ناکامل: کجا میتوانیم تصمیم بگیریم؟
- 28. چرا یادگیری تقویتی برای کنترل این الگوریتم مناسب است؟
- 29. چارچوببندی کنترل تجزیه بندر ناکامل به عنوان یک مسئله یادگیری تقویتی
- 30. تعریف "محیط" (Environment): الگوریتم تجزیه بندر
- 31. تعریف "عامل" (Agent): کنترلکننده هوشمند
- 32. تعریف "حالت" (State): نمایش اطلاعات جاری فرآیند بهینهسازی
- 33. مهندسی ویژگی برای نمایش حالت: چه اطلاعاتی مهم است؟
- 34. ویژگیهای مرتبط با مسئله اصلی (Master Problem)
- 35. ویژگیهای مرتبط با زیرمسئله (Subproblem)
- 36. ویژگیهای مرتبط با تاریخچه فرآیند حل (مانند پیشرفت گپ دوگان)
- 37. تعریف "عمل" (Action): تصمیمات کنترلی در الگوریتم
- 38. نمونه عمل: تعیین سطح دقت حل زیرمسئله
- 39. نمونه عمل: انتخاب نوع برش برای تولید (قویترین در مقابل سریعترین)
- 40. نمونه عمل: تصمیم برای اجرای مراحل تثبیتسازی (Stabilization)
- 41. گسستهسازی یا پیوستهسازی فضای عمل
- 42. تعریف "پاداش" (Reward): ارزیابی کیفیت تصمیمات
- 43. طراحی تابع پاداش برای تشویق همگرایی سریع
- 44. پاداش مبتنی بر کاهش گپ بهینگی (Primal-Dual Gap)
- 45. پاداش مبتنی بر زمان محاسباتی
- 46. چالش پاداشهای تأخیری (Delayed Rewards)
- 47. یک اپیزود (Episode) در این چارچوب: حل یک نمونه مسئله بهینهسازی
- 48. انتخاب معماری عامل هوشمند: شبکههای عصبی عمیق
- 49. شبکههای عصبی پیشخور (Feedforward Neural Networks) برای نمایش سیاست
- 50. طراحی معماری شبکه: لایههای ورودی، پنهان و خروجی
- 51. آموزش عامل: جمعآوری تجربه از طریق تعامل با محیط
- 52. الگوریتمهای یادگیری سیاست (Policy Gradient Methods)
- 53. الگوریتم REINFORCE
- 54. الگوریتمهای بازیگر-منتقد (Actor-Critic): A2C و A3C
- 55. الگوریتم بهینهسازی سیاست پروگزیمال (PPO) و مزایای آن
- 56. پیادهسازی محیط یادگیری: ادغام یک حلگر MILP (مانند Gurobi/CPLEX) با یک فریمورک RL
- 57. ایجاد واسط برنامهنویسی کاربردی (API) برای کنترل حلگر
- 58. نحوه استخراج اطلاعات "حالت" از حلگر در هر تکرار
- 59. نحوه اجرای "عمل" و اعمال تنظیمات جدید به حلگر
- 60. تولید دادههای آموزشی: ساخت مجموعهای متنوع از مسائل MILP
- 61. اهمیت تنوع در دادهها برای تعمیمپذیری سیاست
- 62. مراحل پیشپردازش دادهها و نرمالسازی ویژگیهای حالت
- 63. شروع فرآیند آموزش: حلقه تعامل عامل و محیط
- 64. مدیریت حافظه تجربه (Replay Buffer)
- 65. تنظیم فراپارامترهای یادگیری تقویتی (نرخ یادگیری، ضریب تخفیف)
- 66. تحلیل منحنیهای یادگیری: پاداش تجمعی در طول زمان
- 67. ارزیابی عملکرد سیاست آموختهشده
- 68. متریکهای ارزیابی: زمان کل حل، تعداد تکرارها، گپ نهایی
- 69. مجموعه دادههای تست: ارزیابی بر روی مسائل دیده نشده
- 70. مقایسه با روشهای پایه (Baselines)
- 71. مقایسه با تجزیه بندر کلاسیک (دقیق)
- 72. مقایسه با استراتژیهای کنترلی ایستا و ابتکاری (Heuristics)
- 73. تجسم و تحلیل سیاست آموختهشده: عامل چه چیزی یاد گرفته است؟
- 74. تحلیل حساسیت نسبت به ویژگیهای مختلف حالت
- 75. بررسی تصمیمات عامل در مراحل مختلف فرآیند حل
- 76. مطالعه موردی ۱: حل مسائل تخصیص تسهیلات (Facility Location)
- 77. مطالعه موردی ۲: حل مسائل طراحی شبکه (Network Design)
- 78. چالشهای عملی: پایداری فرآیند آموزش
- 79. راهکارهای مقابله با ناپایداری در آموزش RL
- 80. تعمیمپذیری (Generalization) سیاست در میان کلاسهای مختلف مسائل
- 81. انتقال یادگیری (Transfer Learning) بین مسائل بهینهسازی
- 82. مفاهیم پیشرفته: استفاده از شبکههای عصبی گراف (GNN) برای نمایش حالت
- 83. بهرهگیری از ساختار گرافگونه مسائل بهینهسازی
- 84. مفاهیم پیشرفته: کنترل همزمان چندین پارامتر
- 85. یادگیری تقویتی چند عاملی (Multi-Agent RL) برای بهینهسازی توزیعشده
- 86. کاربردهای صنعتی: زنجیره تأمین و لجستیک
- 87. کاربردهای صنعتی: برنامهریزی تولید و زمانبندی
- 88. کاربردهای صنعتی: بهینهسازی در شبکههای انرژی
- 89. محدودیتهای رویکرد مبتنی بر یادگیری تقویتی
- 90. نیاز به دادههای آموزشی حجیم و زمان محاسباتی برای آموزش
- 91. تفسیرپذیری پایین مدلهای یادگیری عمیق
- 92. مروری بر سایر روشهای یادگیری ماشین برای بهینهسازی الگوریتمی
- 93. یادگیری نظارتشده برای پیشبینی پارامترهای الگوریتم
- 94. یادگیری برای انشعاب و برش (Learning to Branch and Cut)
- 95. آینده پژوهش: ادغام عمیقتر هوش مصنوعی و تحقیق در عملیات
- 96. خلاصه دوره و جمعبندی نکات کلیدی
- 97. پروژه نهایی: پیادهسازی و آموزش یک عامل هوشمند برای کنترل تجزیه بندر ناکامل
- 98. راهنمای پروژه: انتخاب مسئله، پیادهسازی و گزارشدهی نتایج
- 99. نتیجهگیری: به سوی نسل جدید حلگرهای بهینهسازی هوشمند
SMART LEARNING PLATFORM
از مطالعه تا یادگیری ماندگار
فراتر از یک مجموعه فلشکارت؛ تجربهای تعاملی برای یادگیری، تمرین، مرور هوشمند و مشاهده مسیر پیشرفت شما، همراه با امکان دریافت گواهی پایان دوره در دورههای واجد شرایط.
مرور فاصلهدار
آمار یادگیری
گواهی دوزبانه
یادگیری را به یک مسیر قابل پیگیری تبدیل کنید
با ورود به سامانه آموزشی، محتوای دوره را بهصورت مرحلهای دنبال کنید، فلشکارتها را مرور کنید، دانش خود را با پرسشها و آزمونها بسنجید و روند پیشرفتتان را در طول مسیر ببینید.
⟳
مرور فاصلهدار هوشمند
با مرور زماندار، کارتهای تازه و کارتهای سررسیدشده را بر اساس برنامه مرور دنبال کنید. ارزیابی پاسخها به زمانبندی مرورهای بعدی کمک میکند تا تمرین متناسبتری داشته باشید.
◉
مشاهده مسیر پیشرفت
میزان مشاهده فلشکارتها، فعالیتهای مرور، عملکرد آزمونها و آمار یادگیری را بررسی کنید و تصویر روشنتری از مسیر آموزشی خود داشته باشید.
▤
یادگیری مرحلهبهمرحله
فصلها و بخشهای آموزشی را به ترتیب دنبال کنید، مطالب دیدهنشده را پیدا کنید و بدون سردرگمی به ادامه مسیر برگردید.
✓
تمرین و سنجش آموختهها
با نکتههای آموزشی، پرسش و پاسخ، کوییزها و آزمونهای پایان فصل، دانستههای خود را تمرین کنید و بخشهایی را که به توجه بیشتری نیاز دارند بشناسید.
SMART REVIEW
هر بار، مرور هدفمندتر
لازم نیست هر روز از ابتدا درباره اینکه چه چیزی را مرور کنید تصمیم بگیرید. سامانه، صف مرور روزانه را بر اساس کارتهای تازه و موعد مرور کارتها آماده میکند. شما پاسخ را ارزیابی میکنید و برنامه مرور با توجه به آن تنظیم میشود.
دوباره
برای کارتهایی که به تمرین زودتر نیاز دارند.
سخت
برای پاسخهایی که با دشواری به یاد آمدهاند.
خوب
برای پاسخهایی که بهدرستی به یاد آوردهاید.
آسان
برای کارتهایی که پاسخ آنها را بهآسانی میدانید.
برنامه مرور بر اساس ارزیابی شما تنظیم میشود؛ مرور منظم میتواند به تثبیت آموختهها کمک کند، اما بهتنهایی تضمینکننده تسلط کامل نیست.
محتوا را به شیوههای مختلف تمرین کنید
ساختار دورهها متناسب با موضوع آموزشی طراحی شده است و ممکن است انواع مختلفی از محتوا را در بر بگیرد.
نکتههای ساده
برای مرور سریع مفاهیم اصلی و نکات کلیدی.
نکتههای رسمی
برای تمرین تعاریف، اصطلاحات و بیان دقیق علمی.
کوییز
برای سنجش درک مطلب و بررسی گزینه صحیح.
پرسش و پاسخ
برای تمرین یادآوری و سنجش میزان تسلط بر مطالب.
محتوای هر دوره بر اساس ساختار و امکانات فعال همان دوره ارائه میشود.
LEARN ANYWHERE
همراه شما روی مرورگر
برای استفاده از نسخه تحت وب، کافی است با حساب کاربری خود وارد سامانه شوید. بدون نیاز به نصب یک برنامه اختصاصی، میتوانید از مرورگر سازگار روی گوشی، تبلت یا رایانه به دورههای در دسترس خود مراجعه کنید.
گوشی هوشمند
برای مطالعه در زمانهای کوتاه
تبلت و لپتاپ
برای مطالعه و مرور راحتتر
حساب کاربری شخصی
برای دسترسی به دورههای مجاز شما
COURSE COMPLETION CERTIFICATE
گواهی پایان دوره؛ ثبت دستاورد شما
در دورههایی که امکان دریافت گواهی برای آنها فعال است، میتوانید پس از تکمیل شرایط آموزشی، درخواست گواهی پایان دوره ثبت کنید.
شرایط درخواست گواهی
✓ داشتن دسترسی دارای قابلیت گواهی برای دوره مربوطه.
✓ تکمیل اطلاعات لازم در پروفایل، شامل کد ملی معتبر، عکس پرسنلی و نام و نام خانوادگی انگلیسی.
✓ مشاهده تمام فلشکارتهای فعال دوره.
✓ قبولی در آزمونهای پایان فصل، در صورت وجود آزمون برای فصلها.
فارسی و انگلیسی
پس از تأیید و انتشار، نسخههای فارسی و انگلیسی گواهی در دسترس قرار میگیرند.
استعلام آنلاین
گواهی منتشرشده دارای QR Code و لینک اختصاصی برای بررسی آنلاین اعتبار آن است.
دانلود و چاپ
پس از انتشار گواهی، امکان دریافت نسخه PDF فارسی و انگلیسی و چاپ آن فراهم است.
توجه: ثبت درخواست به معنای صدور قطعی نیست. درخواست گواهی پس از بررسی و تأیید ادمین منتشر میشود. این گواهی، گواهی پایان دوره آموزشی است و بهخودیخود معادل مدرک دانشگاهی یا مدرک رسمی مورد تأیید نهادهای دولتی نیست.
یادگیری را شروع کنید؛ پیشرفت را دنبال کنید
با تمرین منظم، مرور هدفمند و پیگیری مسیر آموزشی خود، قدمبهقدم دانش و مهارتهایتان را گسترش دهید.
هر کارت، یک قدم به جلو
امکانات محتوایی، مرور و گواهی بر اساس سطح دسترسی و تنظیمات هر دوره متفاوت است.
نگاهی به محیط سامانه
یادگیری هوشمند، قدمبهقدم
با محیط سامانه آموزشی آشنا شوید و نمونههایی از فضای یادگیری، فلشکارتها و ابزارهای مرور و تمرین را مشاهده کنید.
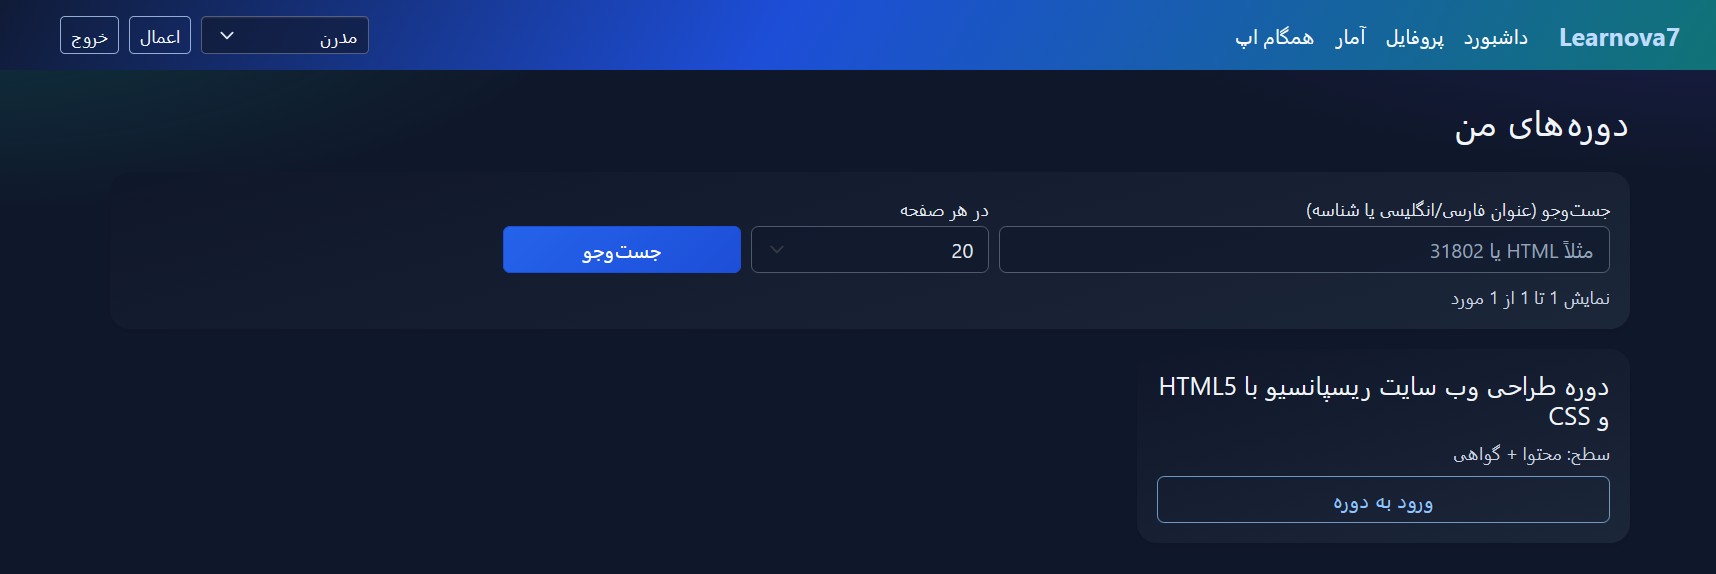
محیط سامانه آموزشی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
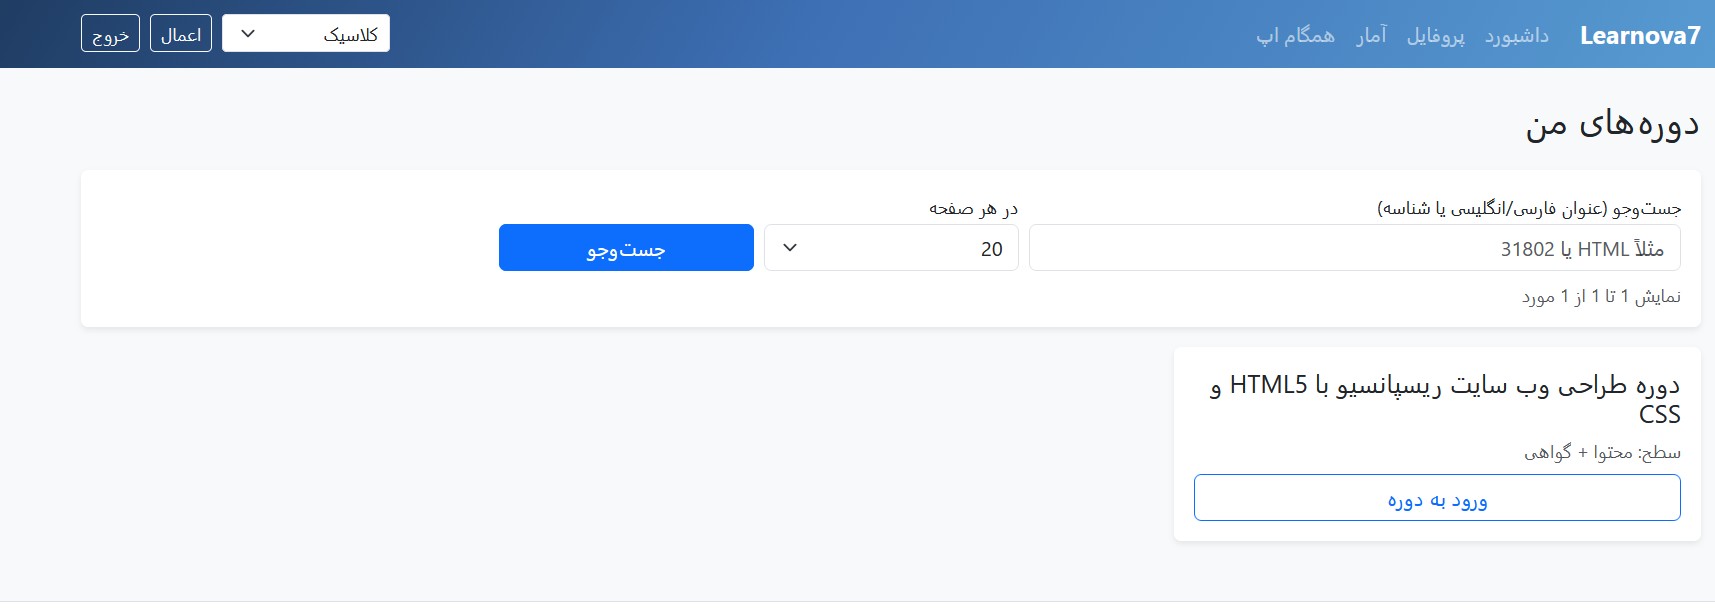
یادگیری و مرور مطالب
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
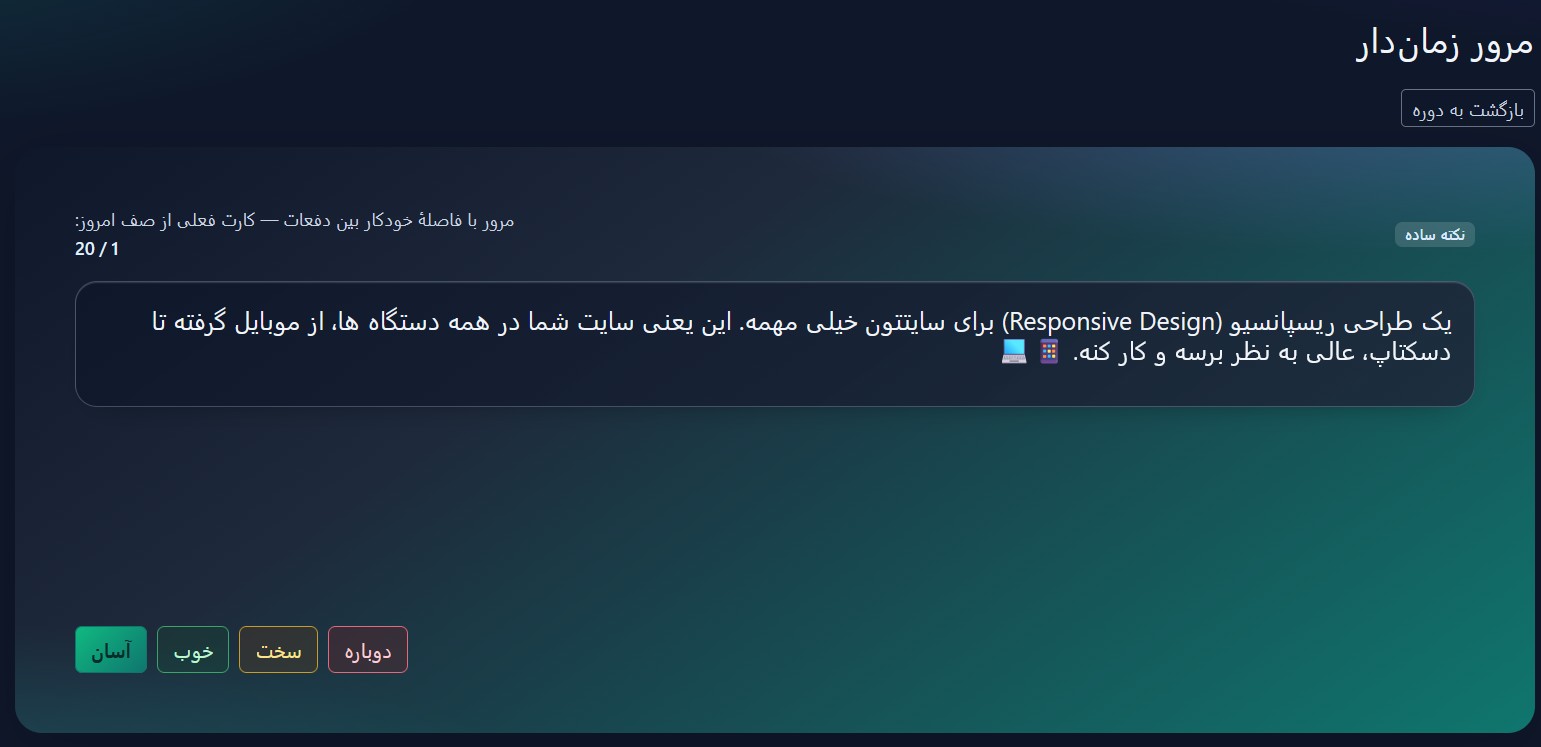
تجربه مطالعه تعاملی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
امکانات بیشتر سامانه
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
یادگیری فراتر از مطالعه معمولی
با فلشکارتهای آموزشی، مرور هدفمند و تمرین مستمر، مطالب را فعالانه یاد بگیرید و مسیر پیشرفت خود را دنبال کنید.
تگها:
AI in Optimization
Artificial Intelligence
Benders Decomposition
Learning to Control
Machine Learning
Optimization
Optimization algorithms
Optimization Automation
reinforcement learning
Research Paper
scientific paper
Smart Control
اتوماسیون بهینهسازی
الگوریتمهای بهینهسازی
بهینهسازی
پردازش تحقیقاتی
تجزیه بندر
کنترل هوشمند
مقاله علمی
هوش مصنوعی
هوش مصنوعی در بهینهسازی
یادگیری برای کنترل
یادگیری تقویتی
یادگیری ماشین
نظرات
هنوز نظری ثبت نشده است.
وارد شوید تا نظر ثبت کنید.