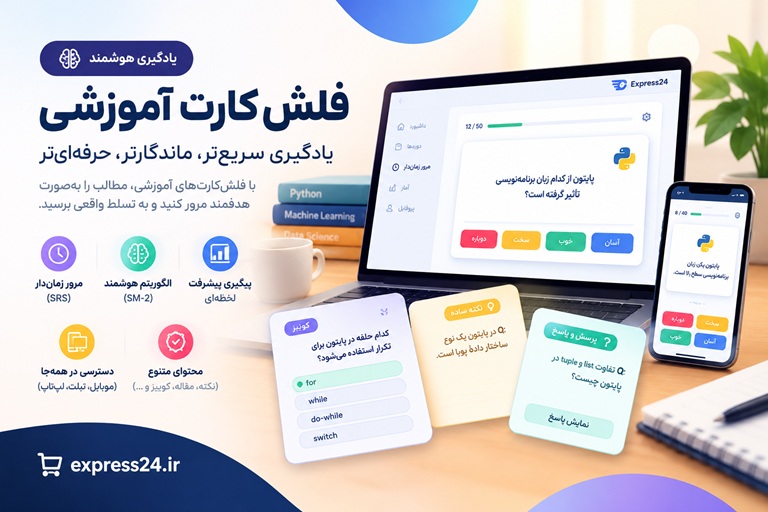
فلشکارتهای آموزشی حل هوشمند، نه مکرر: بهینهسازی هزینه تجدید حل MILP با یادگیری سیاست پیشرفته
حل هوشمند، نه مکرر: بهینهسازی پیشرفته با هوش مصنوعی حل هوشمند، نه مکرر: بهینهسازی هزینه تجدید حل MILP با یادگیری سیاست پیشرفته آیا در دنیای پیچیده مدیریت عملیات، به دنبال راهی هستید تا تصمیمات بهینه...
🎓 دوره آموزشی جامع
📚 اطلاعات دوره
عنوان دوره: دوره حل هوشمند، نه مکرر: بهینهسازی هزینه تجدید حل MILP با یادگیری سیاست پیشرفته
موضوع کلی: هوش مصنوعی برای مدیریت عملیات پیشرفته
موضوع میانی: یادگیری سیاست (Policy Learning) در بهینهسازی پویا و زمان واقعی
📋 سرفصلهای دوره
- 1. بخش اول: مبانی و مقدمات**
- 2. مقدمهای بر مدیریت عملیات پیشرفته و بهینهسازی
- 3. چالشهای تصمیمگیری در دنیای واقعی: پویایی و عدم قطعیت
- 4. آشنایی با برنامهریزی ریاضی و انواع آن
- 5. مبانی برنامهریزی خطی (Linear Programming - LP)
- 6. معرفی برنامهریزی خطی عدد صحیح مختلط (Mixed-Integer Linear Programming - MILP)
- 7. چرا مسائل MILP سخت و پرهزینه هستند؟ پیچیدگی محاسباتی
- 8. مفهوم "تجدید حل" (Re-solving) در محیطهای پویا
- 9. هزینههای پنهان و آشکار تجدید حل مکرر
- 10. معرفی مقاله الهامبخش: "Solve Smart, Not Often" و فلسفه آن
- 11. پارادایم جدید: کنترل فرآیند بهینهسازی با هوش مصنوعی
- 12. مقدمهای بر یادگیری ماشین برای تصمیمگیری
- 13. یادگیری سیاست (Policy Learning) چیست؟
- 14. یادگیری نظارتشده، نظارتنشده و تقویتی: یک مرور کلی
- 15. جایگاه یادگیری سیاست در بهینهسازی عملیات
- 16. بخش دوم: صورتبندی مسئله "حل هوشمند"**
- 17. تعریف رسمی مسئله: چه زمانی باید MILP را دوباره حل کنیم؟
- 18. چارچوب تصمیمگیری: وضعیت، عمل، پاداش
- 19. تعریف "وضعیت سیستم" (System State) برای سیاست
- 20. مهندسی ویژگی (Feature Engineering): استخراج اطلاعات کلیدی از وضعیت سیستم
- 21. ویژگیهای مبتنی بر زمان: زمان سپریشده از آخرین حل
- 22. ویژگیهای مبتنی بر تغییرات: بزرگی تغییر در دادههای ورودی
- 23. ویژگیهای پیشبینانه: تخمین تأثیر تغییرات آینده
- 24. فضای عمل (Action Space): "حل کن" در مقابل "حل نکن"
- 25. تعریف هزینه ساباپتیمالیتی (Cost of Sub-optimality)
- 26. محاسبه پشیمانی (Regret): هزینه استفاده از راهحل قدیمی
- 27. توازن (Trade-off) بین هزینه محاسباتی و هزینه ساباپتیمالیتی
- 28. استراتژیهای تولید داده برای آموزش سیاست
- 29. شبیهسازی محیطهای پویا برای جمعآوری دادههای آموزشی
- 30. برچسبگذاری دادهها: تعیین عمل بهینه (Optimal Action) به صورت آفلاین
- 31. معیارهای ارزیابی عملکرد سیاست: دقت، صرفهجویی در هزینه و کیفیت راهحل
- 32. بخش سوم: یادگیری سیاست با رویکرد یادگیری نظارتشده**
- 33. نگاه به مسئله به عنوان یک طبقهبندی دوتایی (Binary Classification)
- 34. آمادهسازی مجموعه داده: ویژگیها و برچسبها (Solve/Don't Solve)
- 35. مدلهای پایه: رگرسیون لجستیک و ماشینهای بردار پشتیبان (SVM)
- 36. استفاده از درختهای تصمیم و جنگلهای تصادفی (Random Forests)
- 37. مدلهای تقویتی گرادیان (Gradient Boosting Machines)
- 38. شبکههای عصبی کمعمق برای یادگیری سیاست
- 39. معماری شبکههای عصبی عمیق (Deep Neural Networks) برای طبقهبندی
- 40. انتخاب تابع فعالسازی و بهینهساز مناسب
- 41. فرآیند آموزش، اعتبارسنجی و تست مدل سیاست
- 42. تکنیکهای مقابله با عدم توازن دادهها (Imbalanced Data)
- 43. تنظیم هایپرپارامترها برای مدلهای یادگیری سیاست
- 44. تحلیل منحنی ROC و ماتریس درهمریختگی (Confusion Matrix)
- 45. تفسیرپذیری مدلها: چرا مدل تصمیم به "حل" یا "عدم حل" گرفت؟
- 46. محدودیتهای رویکرد یادگیری نظارتشده
- 47. بخش چهارم: یادگیری سیاست با رویکرد یادگیری تقویتی**
- 48. چارچوب فرآیند تصمیمگیری مارکوف (Markov Decision Process - MDP) برای مسئله تجدید حل
- 49. تعریف مجدد وضعیت، عمل، تابع انتقال و پاداش در چارچوب MDP
- 50. تابع پاداش: ترکیب هزینه محاسباتی و پشیمانی
- 51. مقدمهای بر یادگیری تقویتی مبتنی بر ارزش (Value-based RL)
- 52. الگوریتم Q-Learning و جدول Q
- 53. چالشهای فضای وضعیت پیوسته و بزرگ
- 54. یادگیری Q عمیق (Deep Q-Networks - DQN)
- 55. معماری شبکه DQN برای تخمین ارزش عمل
- 56. تکنیکهای کلیدی در DQN: بافر تجربه (Experience Replay) و شبکه هدف (Target Network)
- 57. آموزش مدل DQN با دادههای شبیهسازیشده
- 58. یادگیری تقویتی مبتنی بر سیاست (Policy-based RL)
- 59. الگوریتمهای گرادیان سیاست (Policy Gradient)
- 60. الگوریتم Actor-Critic و مزایای آن
- 61. مقایسه رویکردهای یادگیری نظارتشده و تقویتی برای این مسئله
- 62. بخش پنجم: پیادهسازی و یکپارچهسازی سیستم**
- 63. معماری سیستم: یکپارچهسازی مدل سیاست با حلکننده MILP
- 64. انتخاب حلکننده MILP: Gurobi, CPLEX, SCIP
- 65. ابزارها و کتابخانههای یادگیری ماشین: TensorFlow, PyTorch, Scikit-learn
- 66. جریان کاری دادهها: از دریافت دادههای جدید تا اجرای سیاست
- 67. طراحی یک API برای ارتباط بین ماژول سیاست و ماژول بهینهسازی
- 68. مدیریت زمانبندی: اجرای سیاست در فواصل زمانی مشخص
- 69. پیادهسازی حلقه کنترلی: مشاهده وضعیت، استنتاج سیاست، اجرای عمل
- 70. مثال عملی: کدنویسی یک سیاست ساده با استفاده از درخت تصمیم
- 71. مثال عملی: پیادهسازی یک سیاست مبتنی بر DQN
- 72. لاگبرداری و مانیتورینگ عملکرد سیستم در محیط واقعی
- 73. بخش ششم: مطالعات موردی و کاربردها**
- 74. کاربرد در بهینهسازی زنجیره تأمین در زمان واقعی
- 75. مطالعه موردی: مدیریت موجودی پویا
- 76. کاربرد در مسیریابی وسایل نقلیه پویا (Dynamic Vehicle Routing Problem)
- 77. مطالعه موردی: مدیریت ناوگان تحویل آنلاین
- 78. کاربرد در بهینهسازی شبکههای انرژی و Smart Grid
- 79. مطالعه موردی: زمانبندی تولید برق با تقاضای متغیر
- 80. کاربرد در زمانبندی تولید و تخصیص منابع در کارخانه هوشمند
- 81. مطالعه موردی: واکنش به خرابی دستگاهها در خط تولید
- 82. تحلیل نتایج مطالعات موردی: مقایسه با روشهای سنتی (حل دورهای ثابت)
- 83. ارزیابی میزان صرفهجویی در زمان و هزینه محاسباتی
- 84. تحلیل تأثیر سیاست بر کیفیت نهایی راهحلها
- 85. بخش هفتم: موضوعات پیشرفته و چشمانداز آینده**
- 86. گسترش فضای عمل: انتخاب بین حلکنندههای مختلف (دقیق در مقابل هیوریستیک)
- 87. سیاستهای چند گزینهای: "عدم حل"، "حل تقریبی"، "حل کامل"
- 88. مدیریت عدم قطعیت در پارامترهای ورودی مدل MILP
- 89. یادگیری سیاست مقاوم در برابر عدم قطعیت (Robust Policy Learning)
- 90. یادگیری آنلاین (Online Learning) و انطباق سیاست در طول زمان
- 91. چالشهای مقیاسپذیری: اجرای سیستم برای مسائل بسیار بزرگ
- 92. استفاده از محاسبات موازی و توزیعشده
- 93. یادگیری انتقالی (Transfer Learning) برای سیاستها در دامنههای مختلف
- 94. تکنیکهای پیشرفته مهندسی ویژگی با استفاده از یادگیری عمیق
- 95. ملاحظات اخلاقی و مسئولیتپذیری در سیستمهای تصمیمگیری خودکار
- 96. روندهای آینده: ترکیب یادگیری سیاست با سایر تکنیکهای بهینهسازی
- 97. خلاصه دوره و جمعبندی نکات کلیدی
- 98. پروژه نهایی: طراحی و پیادهسازی کامل یک سیستم "حل هوشمند" برای یک مسئله منتخب
SMART LEARNING PLATFORM
از مطالعه تا یادگیری ماندگار
فراتر از یک مجموعه فلشکارت؛ تجربهای تعاملی برای یادگیری، تمرین، مرور هوشمند و مشاهده مسیر پیشرفت شما، همراه با امکان دریافت گواهی پایان دوره در دورههای واجد شرایط.
مرور فاصلهدار
آمار یادگیری
گواهی دوزبانه
یادگیری را به یک مسیر قابل پیگیری تبدیل کنید
با ورود به سامانه آموزشی، محتوای دوره را بهصورت مرحلهای دنبال کنید، فلشکارتها را مرور کنید، دانش خود را با پرسشها و آزمونها بسنجید و روند پیشرفتتان را در طول مسیر ببینید.
⟳
مرور فاصلهدار هوشمند
با مرور زماندار، کارتهای تازه و کارتهای سررسیدشده را بر اساس برنامه مرور دنبال کنید. ارزیابی پاسخها به زمانبندی مرورهای بعدی کمک میکند تا تمرین متناسبتری داشته باشید.
◉
مشاهده مسیر پیشرفت
میزان مشاهده فلشکارتها، فعالیتهای مرور، عملکرد آزمونها و آمار یادگیری را بررسی کنید و تصویر روشنتری از مسیر آموزشی خود داشته باشید.
▤
یادگیری مرحلهبهمرحله
فصلها و بخشهای آموزشی را به ترتیب دنبال کنید، مطالب دیدهنشده را پیدا کنید و بدون سردرگمی به ادامه مسیر برگردید.
✓
تمرین و سنجش آموختهها
با نکتههای آموزشی، پرسش و پاسخ، کوییزها و آزمونهای پایان فصل، دانستههای خود را تمرین کنید و بخشهایی را که به توجه بیشتری نیاز دارند بشناسید.
SMART REVIEW
هر بار، مرور هدفمندتر
لازم نیست هر روز از ابتدا درباره اینکه چه چیزی را مرور کنید تصمیم بگیرید. سامانه، صف مرور روزانه را بر اساس کارتهای تازه و موعد مرور کارتها آماده میکند. شما پاسخ را ارزیابی میکنید و برنامه مرور با توجه به آن تنظیم میشود.
دوباره
برای کارتهایی که به تمرین زودتر نیاز دارند.
سخت
برای پاسخهایی که با دشواری به یاد آمدهاند.
خوب
برای پاسخهایی که بهدرستی به یاد آوردهاید.
آسان
برای کارتهایی که پاسخ آنها را بهآسانی میدانید.
برنامه مرور بر اساس ارزیابی شما تنظیم میشود؛ مرور منظم میتواند به تثبیت آموختهها کمک کند، اما بهتنهایی تضمینکننده تسلط کامل نیست.
محتوا را به شیوههای مختلف تمرین کنید
ساختار دورهها متناسب با موضوع آموزشی طراحی شده است و ممکن است انواع مختلفی از محتوا را در بر بگیرد.
نکتههای ساده
برای مرور سریع مفاهیم اصلی و نکات کلیدی.
نکتههای رسمی
برای تمرین تعاریف، اصطلاحات و بیان دقیق علمی.
کوییز
برای سنجش درک مطلب و بررسی گزینه صحیح.
پرسش و پاسخ
برای تمرین یادآوری و سنجش میزان تسلط بر مطالب.
محتوای هر دوره بر اساس ساختار و امکانات فعال همان دوره ارائه میشود.
LEARN ANYWHERE
همراه شما روی مرورگر
برای استفاده از نسخه تحت وب، کافی است با حساب کاربری خود وارد سامانه شوید. بدون نیاز به نصب یک برنامه اختصاصی، میتوانید از مرورگر سازگار روی گوشی، تبلت یا رایانه به دورههای در دسترس خود مراجعه کنید.
گوشی هوشمند
برای مطالعه در زمانهای کوتاه
تبلت و لپتاپ
برای مطالعه و مرور راحتتر
حساب کاربری شخصی
برای دسترسی به دورههای مجاز شما
COURSE COMPLETION CERTIFICATE
گواهی پایان دوره؛ ثبت دستاورد شما
در دورههایی که امکان دریافت گواهی برای آنها فعال است، میتوانید پس از تکمیل شرایط آموزشی، درخواست گواهی پایان دوره ثبت کنید.
شرایط درخواست گواهی
✓ داشتن دسترسی دارای قابلیت گواهی برای دوره مربوطه.
✓ تکمیل اطلاعات لازم در پروفایل، شامل کد ملی معتبر، عکس پرسنلی و نام و نام خانوادگی انگلیسی.
✓ مشاهده تمام فلشکارتهای فعال دوره.
✓ قبولی در آزمونهای پایان فصل، در صورت وجود آزمون برای فصلها.
فارسی و انگلیسی
پس از تأیید و انتشار، نسخههای فارسی و انگلیسی گواهی در دسترس قرار میگیرند.
استعلام آنلاین
گواهی منتشرشده دارای QR Code و لینک اختصاصی برای بررسی آنلاین اعتبار آن است.
دانلود و چاپ
پس از انتشار گواهی، امکان دریافت نسخه PDF فارسی و انگلیسی و چاپ آن فراهم است.
توجه: ثبت درخواست به معنای صدور قطعی نیست. درخواست گواهی پس از بررسی و تأیید ادمین منتشر میشود. این گواهی، گواهی پایان دوره آموزشی است و بهخودیخود معادل مدرک دانشگاهی یا مدرک رسمی مورد تأیید نهادهای دولتی نیست.
یادگیری را شروع کنید؛ پیشرفت را دنبال کنید
با تمرین منظم، مرور هدفمند و پیگیری مسیر آموزشی خود، قدمبهقدم دانش و مهارتهایتان را گسترش دهید.
هر کارت، یک قدم به جلو
امکانات محتوایی، مرور و گواهی بر اساس سطح دسترسی و تنظیمات هر دوره متفاوت است.
نگاهی به محیط سامانه
یادگیری هوشمند، قدمبهقدم
با محیط سامانه آموزشی آشنا شوید و نمونههایی از فضای یادگیری، فلشکارتها و ابزارهای مرور و تمرین را مشاهده کنید.
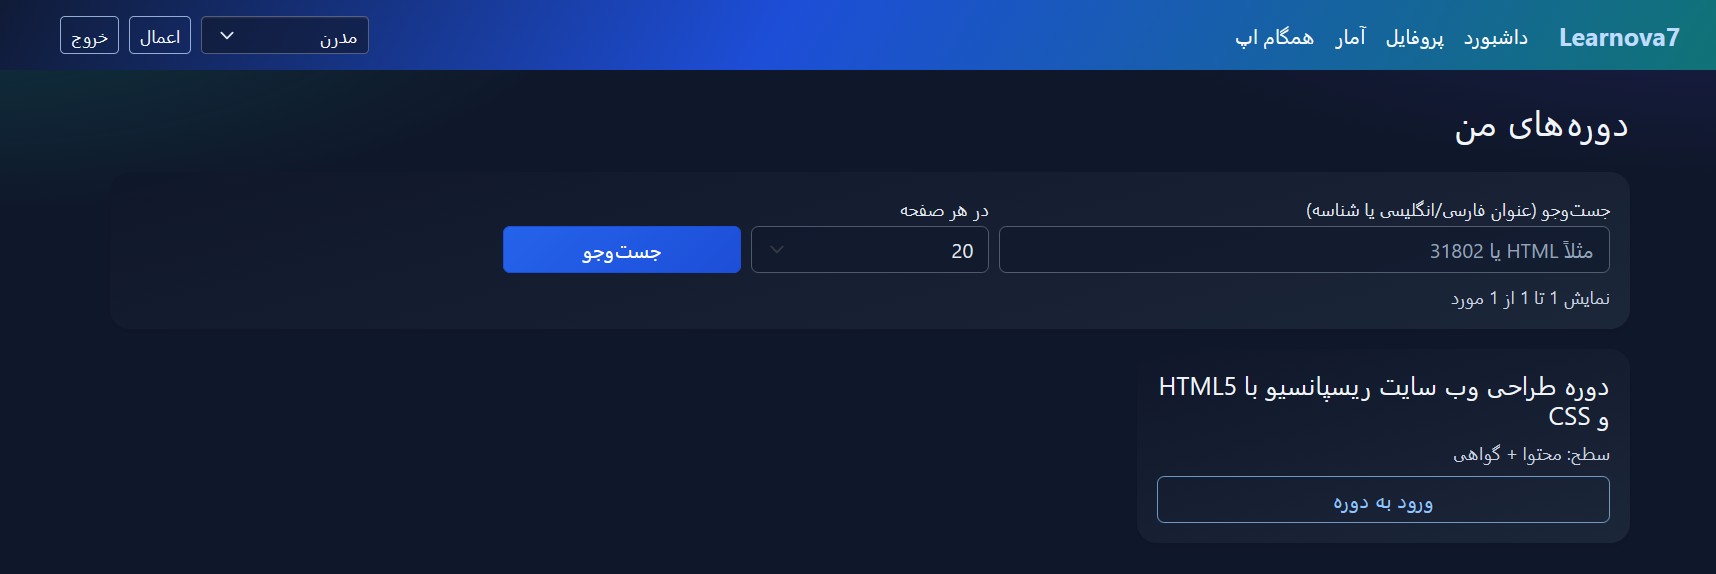
محیط سامانه آموزشی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
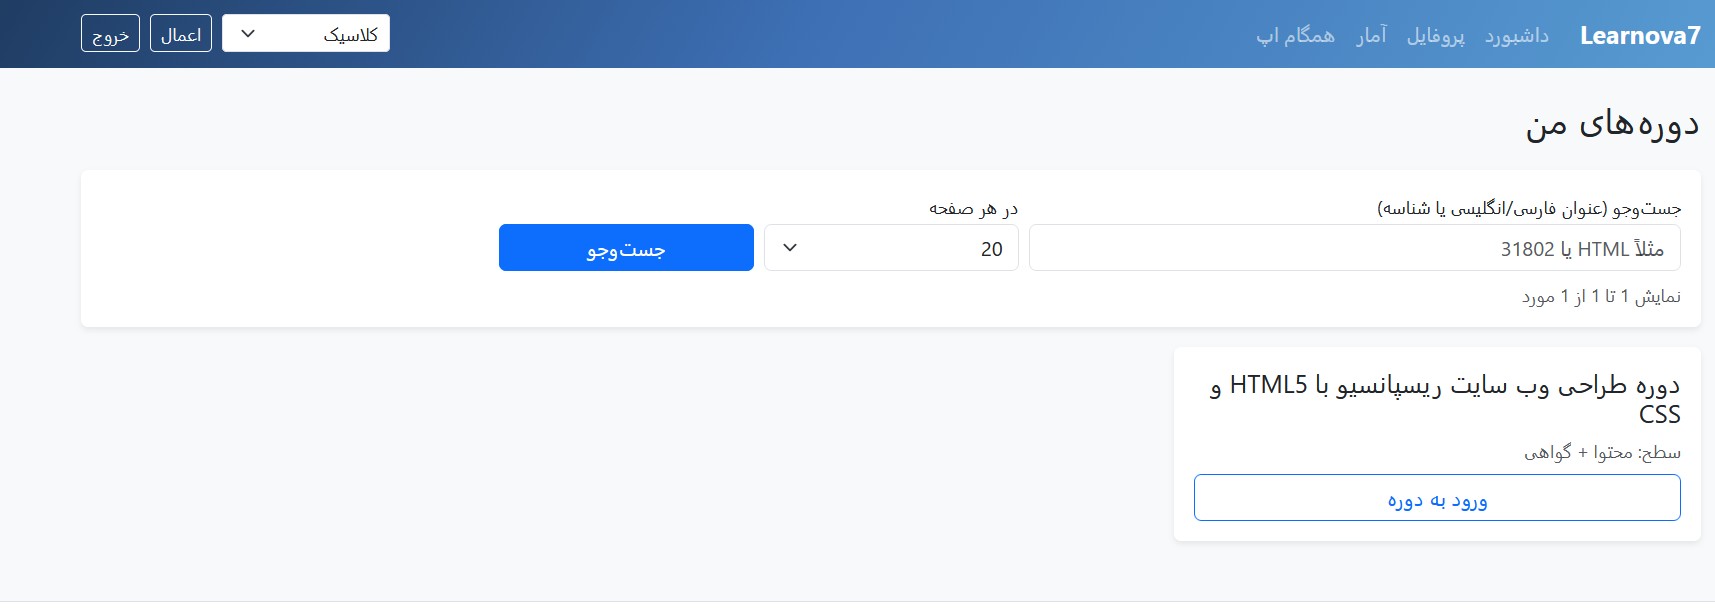
یادگیری و مرور مطالب
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
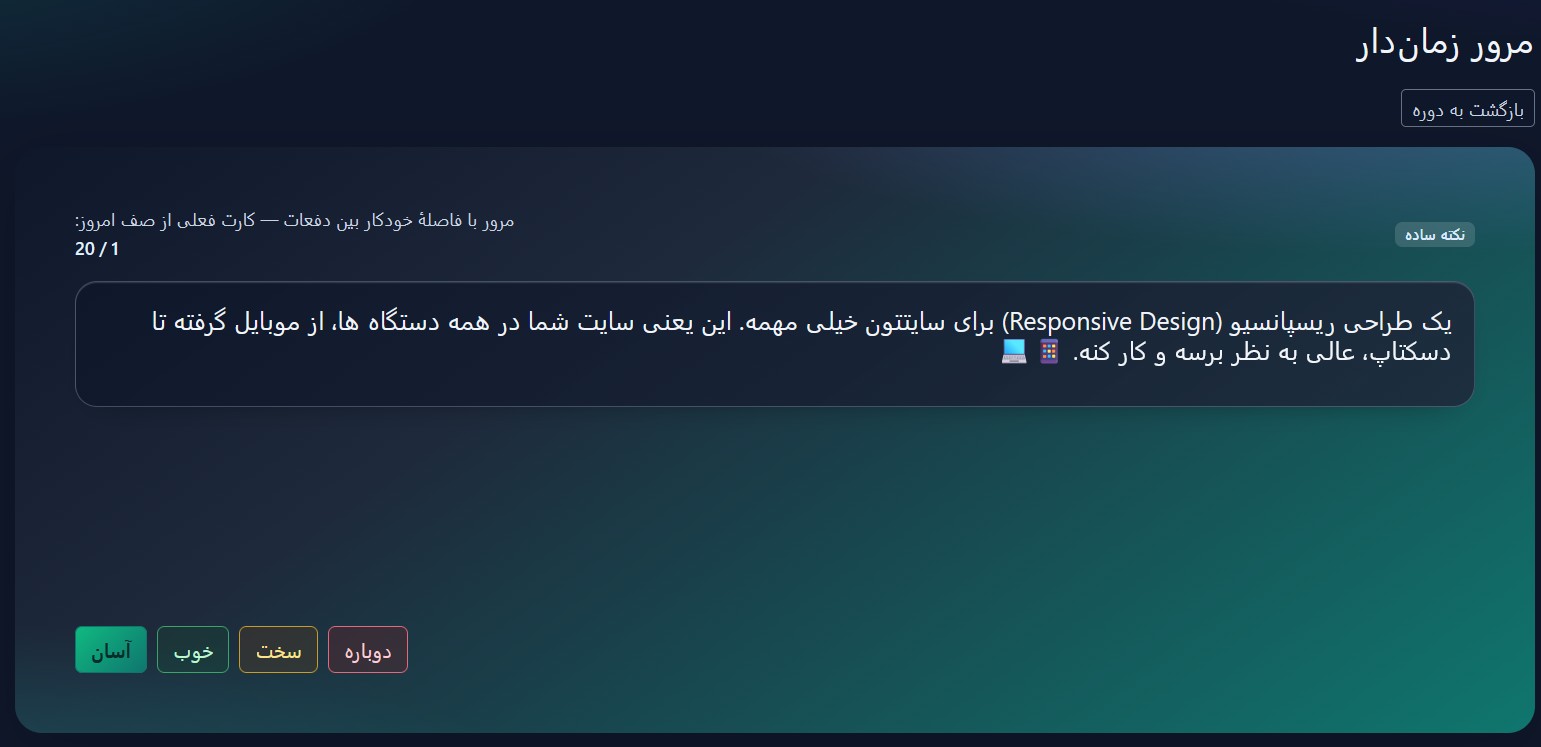
تجربه مطالعه تعاملی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
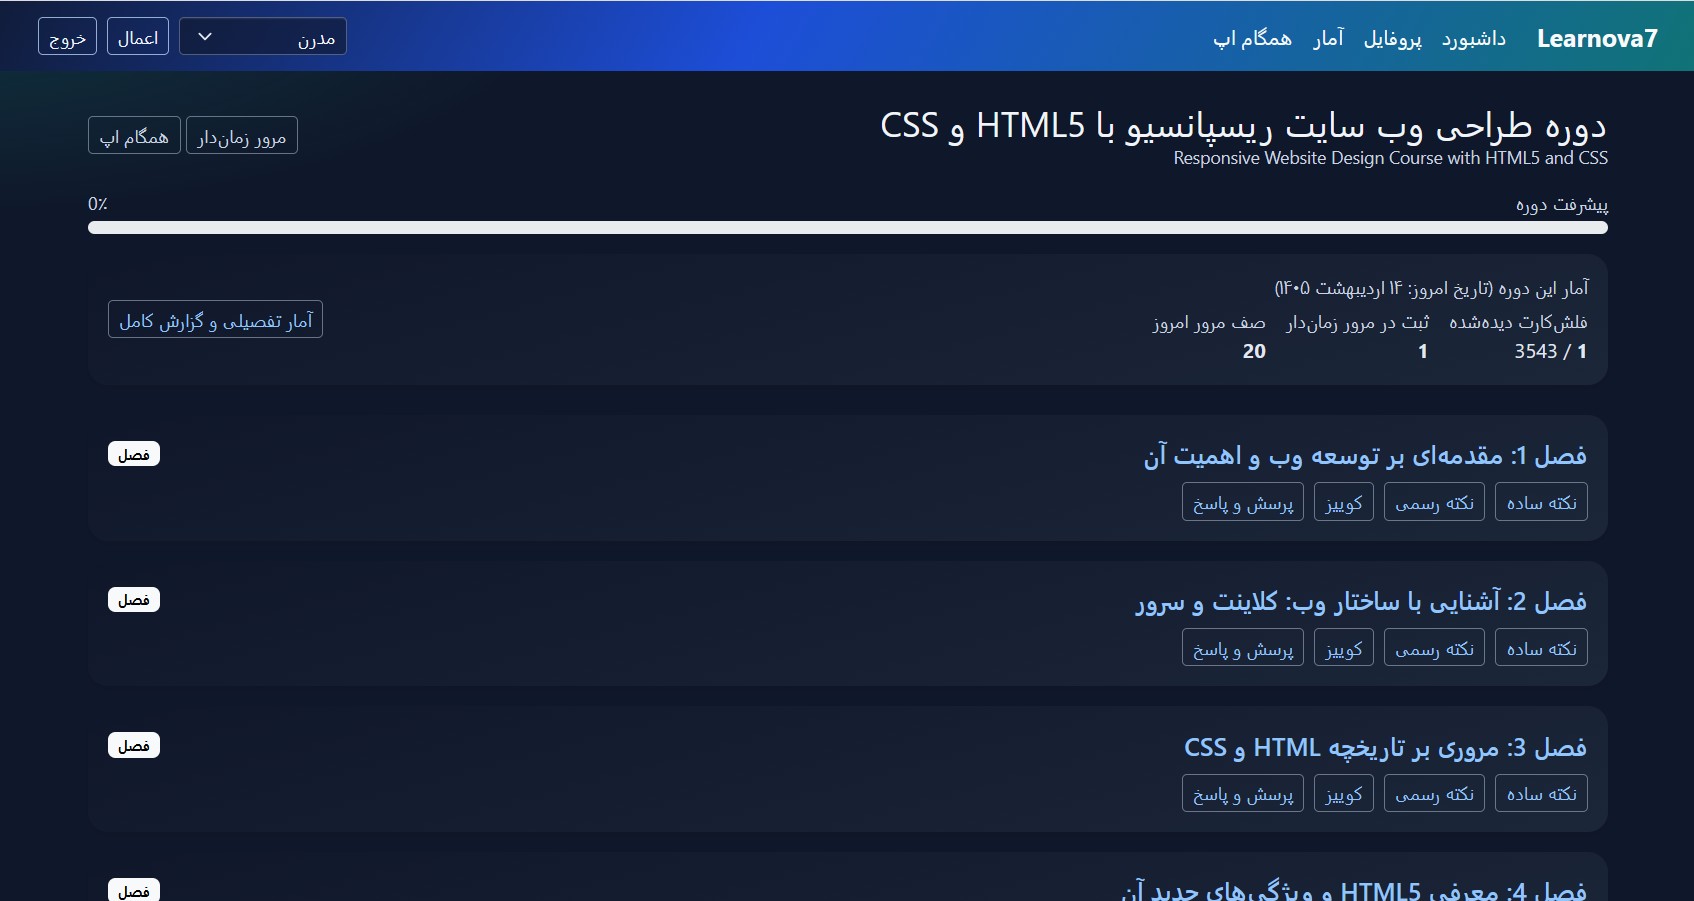
امکانات بیشتر سامانه
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
یادگیری فراتر از مطالعه معمولی
با فلشکارتهای آموزشی، مرور هدفمند و تمرین مستمر، مطالب را فعالانه یاد بگیرید و مسیر پیشرفت خود را دنبال کنید.
تگها:
AI for Operations
Costly Re-solving
MILP
Mixed Integer Linear Programming
Policy Learning
Real-time Optimization
Solve Smart Not Often
بهینهسازی
بهینهسازی پویا
زمان واقعی
مدیریت عملیات
هوش مصنوعی
هوش مصنوعی در صنعت
یادگیری سیاست
یادگیری ماشین
نظرات
هنوز نظری ثبت نشده است.
وارد شوید تا نظر ثبت کنید.