فلشکارتهای آموزشی غلبه بر نفرین برنده در تصمیمگیری درمانی: یک رویکرد مبتنی بر بهینهسازی سیاست آگاه از استنتاج
دوره غلبه بر نفرین برنده در تصمیمگیری درمانی دوره جامع غلبه بر نفرین برنده در تصمیمگیری: از تئوری تا کدنویسی معرفی دوره: چرا بهترین مدلهای پیشبینی، بهترین تصمیمها را نمیسازند؟ آیا تا به حال یک م...
🎓 دوره آموزشی جامع
📚 اطلاعات دوره
عنوان دوره: دوره غلبه بر نفرین برنده در تصمیمگیری درمانی: یک رویکرد مبتنی بر بهینهسازی سیاست آگاه از استنتاج
موضوع کلی: یادگیری تقویتی و تصمیمگیری مبتنی بر داده
موضوع میانی: بهینهسازی سیاستها با در نظر گرفتن عدم قطعیت و خطاهای پیشبینی
📋 سرفصلهای دوره
- 1. مقدمهای بر تصمیمگیری مبتنی بر داده در مراقبتهای بهداشتی
- 2. چالشهای تصمیمگیری درمانی فردی
- 3. مروری بر یادگیری تقویتی: از نظریه تا عمل
- 4. مبانی استنتاج علّی و کاربردهای آن
- 5. پدیده "نفرین برنده": تعاریف و پیامدها
- 6. نفرین برنده در تخمین اثرات درمانی
- 7. لزوم بهینهسازی سیاست آگاه از استنتاج
- 8. اهداف و ساختار کلی دوره آموزشی
- 9. مروری بر مقاله الهامبخش: Beating the Winner's Curse
- 10. آشنایی با مفاهیم کلیدی: سیاست، تابع ارزش، عدم قطعیت
- 11. فرایندهای تصمیمگیری مارکوف (MDPs): تعاریف و اجزا
- 12. عناصر یک MDP: حالتها، عملها، پاداشها، توابع انتقال
- 13. سیاستها: توصیف رفتار عامل در MDP
- 14. تابع ارزش حالت و تابع ارزش عمل-حالت
- 15. معادلات بلمن و اصول بهینگی
- 16. برنامهریزی دینامیک: تکرار سیاست و تکرار ارزش
- 17. یادگیری با استفاده از مدل: مزایا و محدودیتها
- 18. یادگیری بدون مدل: Q-Learning و SARSA
- 19. کاوش و بهرهبرداری در یادگیری تقویتی
- 20. چالشهای یادگیری تقویتی در محیطهای درمانی
- 21. مدل پیامدهای بالقوه (Potential Outcomes Framework)
- 22. اثر درمانی متوسط (Average Treatment Effect - ATE)
- 23. اثر درمانی متوسط شرطی (Conditional Average Treatment Effect - CATE)
- 24. قوانین درمانی فردی (Individualized Treatment Rules - ITRs)
- 25. مفاهیم سوگیری انتخاب و متغیرهای مخدوشکننده
- 26. طرحهای مشاهدهای و آزمایشهای کنترلشده تصادفی (RCTs)
- 27. روشهای بر اساس امتیاز تمایل (Propensity Score Methods)
- 28. تطبیق و وزندهی وارون احتمالات (Matching and Inverse Probability Weighting)
- 29. تخمین CATE با مدلهای یادگیری ماشین
- 30. چالشهای تخمین دقیق CATE در دادههای پزشکی
- 31. مقدمهای بر یادگیری تقویتی آفلاین (Batch RL)
- 32. ضرورت یادگیری آفلاین در کاربردهای حساس مانند پزشکی
- 33. چالش اصلی: اقدامات خارج از توزیع (Out-of-Distribution Actions)
- 34. سوگیری ناشی از دادههای ثابت (Static Data Bias)
- 35. تخمین آفپالسی (Off-Policy Evaluation - OPE)
- 36. روشهای محافظهکارانه در Q-Learning آفلاین (Conservative Q-Learning - CQL)
- 37. محدودیتهای توزیعی در بهینهسازی سیاست آفلاین
- 38. آموزش مدلهای رفتاری (Behavioral Cloning) و محدودیتهای آن
- 39. طراحی الگوریتمهای قوی برای RL آفلاین
- 40. اندازهگیری عدم قطعیت در یادگیری آفلاین
- 41. تعریف رسمی نفرین برنده و مکانیسمهای آماری آن
- 42. نفرین برنده به عنوان یک پدیده سوگیری انتخاب
- 43. مثالهای نفرین برنده در حوزههای مختلف (اقتصاد، بیوانفورماتیک)
- 44. نفرین برنده در انتخاب بهترین درمان بر اساس برآورد اثر
- 45. تاثیر نفرین برنده بر ارزیابی عملکرد سیاستها
- 46. تفاوت نفرین برنده و بیشبرازش (Overfitting)
- 47. مدلسازی ریاضی پدیده نفرین برنده
- 48. شناسایی شرایطی که نفرین برنده تشدید میشود
- 49. راهکارهای اولیه برای کاهش اثر نفرین برنده
- 50. ارزیابی کمی میزان نفرین برنده در یک سیستم
- 51. اهمیت کمیسازی عدم قطعیت در تصمیمگیری
- 52. رویکردهای بیزی برای تخمین اثرات درمانی
- 53. روشهای بوتاسترپ برای محاسبه بازههای اطمینان
- 54. پیشبینی کنفورمال (Conformal Prediction) برای بازههای اطمینان
- 55. مدلسازی واریانس در تخمین CATE (Heteroscedasticity)
- 56. عدم قطعیت معرفتی (Epistemic Uncertainty) و عدم قطعیت تصادفی (Aleatoric Uncertainty)
- 57. نقش عدم قطعیت در انتخاب سیاستهای درمانی
- 58. نمایش عدم قطعیت با استفاده از توزیعها (Distributional CATE)
- 59. روشهای تخمین عدم قطعیت با شبکههای عصبی
- 60. مقایسه رویکردهای مختلف کمیسازی عدم قطعیت
- 61. معرفی بهینهسازی سیاست آگاه از استنتاج
- 62. فرمولبندی مسئله: بهینهسازی سیاست با در نظر گرفتن عدم قطعیت
- 63. اهداف سیاست آگاه از استنتاج: پایداری، اطمینان، عملکرد
- 64. بهینهسازی سیاست مقاوم (Robust Policy Optimization)
- 65. یادگیری تقویتی حساس به ریسک (Risk-Sensitive RL)
- 66. ادغام عدم قطعیت در تابع پاداش یا تابع هزینه
- 67. استفاده از بازههای اطمینان در فرایند تصمیمگیری سیاست
- 68. رویکردهای مینیمم-ماکس (Minimax) در سیاست آگاه از استنتاج
- 69. ارزیابی تعادل بین عملکرد مورد انتظار و ریسک عدم قطعیت
- 70. ساختار الگوریتمی برای بهینهسازی آگاه از استنتاج
- 71. طراحی توابع هدف برای سیاست آگاه از استنتاج
- 72. الگوریتمهای مبتنی بر بهینهسازی بیزی سیاست
- 73. انتشار عدم قطعیت از تخمین CATE به بهینهسازی سیاست
- 74. روشهای ترکیبی از یادگیری عمیق و آمار بیزی
- 75. بهینهسازی سیاست با استفاده از توزیع عدم قطعیت Q-Value
- 76. الگوریتمهای مبتنی بر نمونهبرداری برای بهینهسازی سیاست آگاه از استنتاج
- 77. تکنیکهای کاهش واریانس در آموزش سیاست آگاه از استنتاج
- 78. استفاده از قیدها و محدودیتهای عدم قطعیت در بهینهسازی
- 79. پیادهسازی عملی الگوریتمهای اصلی مقاله "Beating the Winner's Curse"
- 80. ابزارهای نرمافزاری و کتابخانههای مرتبط
- 81. طراحی رژیمهای درمانی دینامیک (Dynamic Treatment Regimes)
- 82. انتخاب درمان بهینه برای بیماریهای مزمن
- 83. بهینهسازی دوز دارو بر اساس پاسخ بیمار
- 84. کاربرد در مدیریت بیماریهای قلبی-عروقی
- 85. کاربرد در سرطانشناسی و انتخاب پروتکل درمانی
- 86. تصمیمگیری درمانی در شرایط اورژانسی با دادههای محدود
- 87. ملاحظات اخلاقی و حریم خصوصی در هوش مصنوعی پزشکی
- 88. ارزیابی عملکرد بالینی سیاستهای آگاه از استنتاج
- 89. تعامل با پزشکان و متخصصان بالینی
- 90. چشمانداز آینده هوش مصنوعی در پزشکی شخصیسازی شده
- 91. ارزیابی آفپالسی سیاستهای آگاه از استنتاج
- 92. یادگیری تقویتی با اهداف چندگانه (Multi-Objective RL)
- 93. تفسیرپذیری و شفافیت سیاستهای درمانی (XAI in Healthcare)
- 94. یادگیری انتقال (Transfer Learning) و دادههای نامتوازن
- 95. یادگیری فعال (Active Learning) برای بهبود جمعآوری داده
- 96. چالشهای مقیاسپذیری در دادههای بزرگ پزشکی
- 97. ترکیب دادههای ساختاریافته و غیرساختاریافته (تصاویر، متن)
- 98. بهینهسازی سیاست با محدودیتهای ایمنی و پایداری
- 99. مروری بر چالشهای تحقیقاتی و مسیرهای آینده
- 100. جمعبندی دوره و افقهای جدید در تصمیمگیری درمانی هوشمند
SMART LEARNING PLATFORM
از مطالعه تا یادگیری ماندگار
فراتر از یک مجموعه فلشکارت؛ تجربهای تعاملی برای یادگیری، تمرین، مرور هوشمند و مشاهده مسیر پیشرفت شما، همراه با امکان دریافت گواهی پایان دوره در دورههای واجد شرایط.
مرور فاصلهدار
آمار یادگیری
گواهی دوزبانه
یادگیری را به یک مسیر قابل پیگیری تبدیل کنید
با ورود به سامانه آموزشی، محتوای دوره را بهصورت مرحلهای دنبال کنید، فلشکارتها را مرور کنید، دانش خود را با پرسشها و آزمونها بسنجید و روند پیشرفتتان را در طول مسیر ببینید.
⟳
مرور فاصلهدار هوشمند
با مرور زماندار، کارتهای تازه و کارتهای سررسیدشده را بر اساس برنامه مرور دنبال کنید. ارزیابی پاسخها به زمانبندی مرورهای بعدی کمک میکند تا تمرین متناسبتری داشته باشید.
◉
مشاهده مسیر پیشرفت
میزان مشاهده فلشکارتها، فعالیتهای مرور، عملکرد آزمونها و آمار یادگیری را بررسی کنید و تصویر روشنتری از مسیر آموزشی خود داشته باشید.
▤
یادگیری مرحلهبهمرحله
فصلها و بخشهای آموزشی را به ترتیب دنبال کنید، مطالب دیدهنشده را پیدا کنید و بدون سردرگمی به ادامه مسیر برگردید.
✓
تمرین و سنجش آموختهها
با نکتههای آموزشی، پرسش و پاسخ، کوییزها و آزمونهای پایان فصل، دانستههای خود را تمرین کنید و بخشهایی را که به توجه بیشتری نیاز دارند بشناسید.
SMART REVIEW
هر بار، مرور هدفمندتر
لازم نیست هر روز از ابتدا درباره اینکه چه چیزی را مرور کنید تصمیم بگیرید. سامانه، صف مرور روزانه را بر اساس کارتهای تازه و موعد مرور کارتها آماده میکند. شما پاسخ را ارزیابی میکنید و برنامه مرور با توجه به آن تنظیم میشود.
دوباره
برای کارتهایی که به تمرین زودتر نیاز دارند.
سخت
برای پاسخهایی که با دشواری به یاد آمدهاند.
خوب
برای پاسخهایی که بهدرستی به یاد آوردهاید.
آسان
برای کارتهایی که پاسخ آنها را بهآسانی میدانید.
برنامه مرور بر اساس ارزیابی شما تنظیم میشود؛ مرور منظم میتواند به تثبیت آموختهها کمک کند، اما بهتنهایی تضمینکننده تسلط کامل نیست.
محتوا را به شیوههای مختلف تمرین کنید
ساختار دورهها متناسب با موضوع آموزشی طراحی شده است و ممکن است انواع مختلفی از محتوا را در بر بگیرد.
نکتههای ساده
برای مرور سریع مفاهیم اصلی و نکات کلیدی.
نکتههای رسمی
برای تمرین تعاریف، اصطلاحات و بیان دقیق علمی.
کوییز
برای سنجش درک مطلب و بررسی گزینه صحیح.
پرسش و پاسخ
برای تمرین یادآوری و سنجش میزان تسلط بر مطالب.
محتوای هر دوره بر اساس ساختار و امکانات فعال همان دوره ارائه میشود.
LEARN ANYWHERE
همراه شما روی مرورگر
برای استفاده از نسخه تحت وب، کافی است با حساب کاربری خود وارد سامانه شوید. بدون نیاز به نصب یک برنامه اختصاصی، میتوانید از مرورگر سازگار روی گوشی، تبلت یا رایانه به دورههای در دسترس خود مراجعه کنید.
گوشی هوشمند
برای مطالعه در زمانهای کوتاه
تبلت و لپتاپ
برای مطالعه و مرور راحتتر
حساب کاربری شخصی
برای دسترسی به دورههای مجاز شما
COURSE COMPLETION CERTIFICATE
گواهی پایان دوره؛ ثبت دستاورد شما
در دورههایی که امکان دریافت گواهی برای آنها فعال است، میتوانید پس از تکمیل شرایط آموزشی، درخواست گواهی پایان دوره ثبت کنید.
شرایط درخواست گواهی
✓ داشتن دسترسی دارای قابلیت گواهی برای دوره مربوطه.
✓ تکمیل اطلاعات لازم در پروفایل، شامل کد ملی معتبر، عکس پرسنلی و نام و نام خانوادگی انگلیسی.
✓ مشاهده تمام فلشکارتهای فعال دوره.
✓ قبولی در آزمونهای پایان فصل، در صورت وجود آزمون برای فصلها.
فارسی و انگلیسی
پس از تأیید و انتشار، نسخههای فارسی و انگلیسی گواهی در دسترس قرار میگیرند.
استعلام آنلاین
گواهی منتشرشده دارای QR Code و لینک اختصاصی برای بررسی آنلاین اعتبار آن است.
دانلود و چاپ
پس از انتشار گواهی، امکان دریافت نسخه PDF فارسی و انگلیسی و چاپ آن فراهم است.
توجه: ثبت درخواست به معنای صدور قطعی نیست. درخواست گواهی پس از بررسی و تأیید ادمین منتشر میشود. این گواهی، گواهی پایان دوره آموزشی است و بهخودیخود معادل مدرک دانشگاهی یا مدرک رسمی مورد تأیید نهادهای دولتی نیست.
یادگیری را شروع کنید؛ پیشرفت را دنبال کنید
با تمرین منظم، مرور هدفمند و پیگیری مسیر آموزشی خود، قدمبهقدم دانش و مهارتهایتان را گسترش دهید.
هر کارت، یک قدم به جلو
امکانات محتوایی، مرور و گواهی بر اساس سطح دسترسی و تنظیمات هر دوره متفاوت است.
نگاهی به محیط سامانه
یادگیری هوشمند، قدمبهقدم
با محیط سامانه آموزشی آشنا شوید و نمونههایی از فضای یادگیری، فلشکارتها و ابزارهای مرور و تمرین را مشاهده کنید.
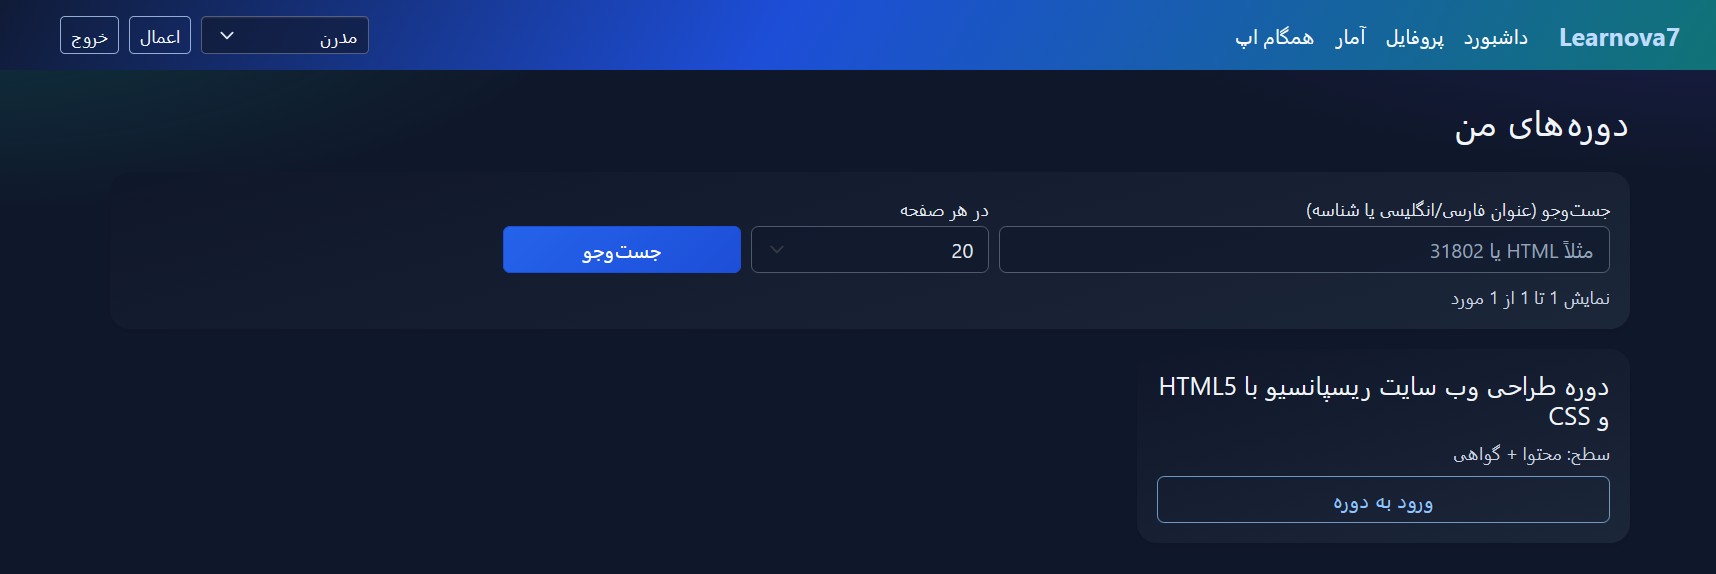
محیط سامانه آموزشی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
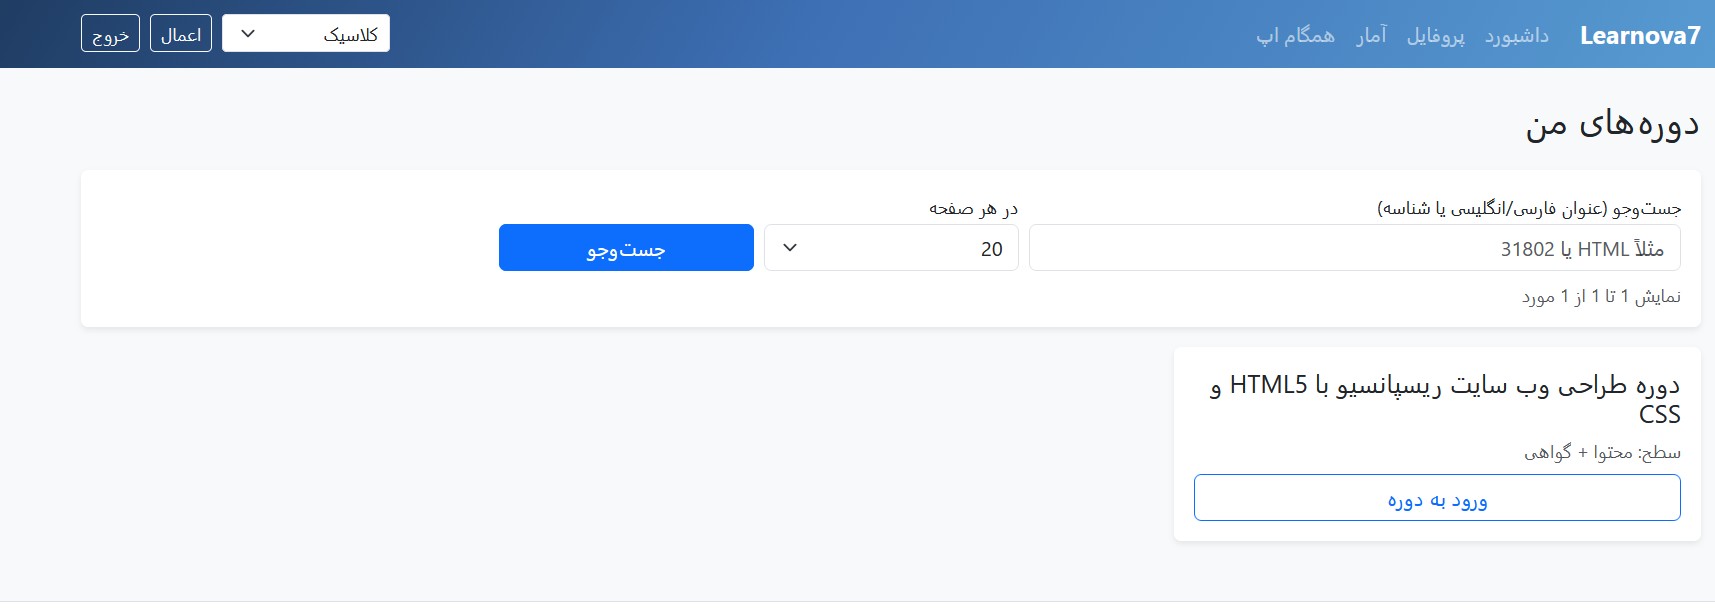
یادگیری و مرور مطالب
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
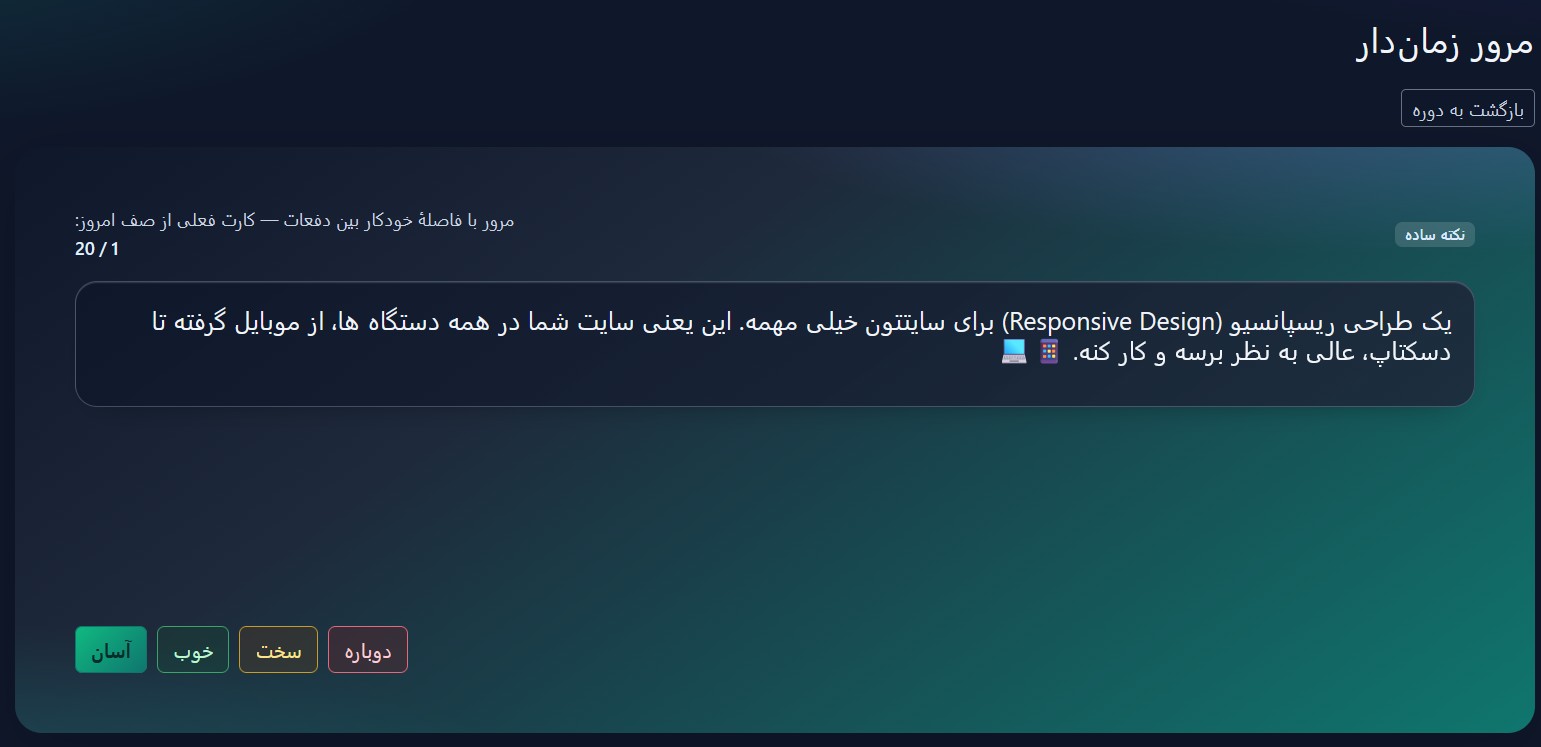
تجربه مطالعه تعاملی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
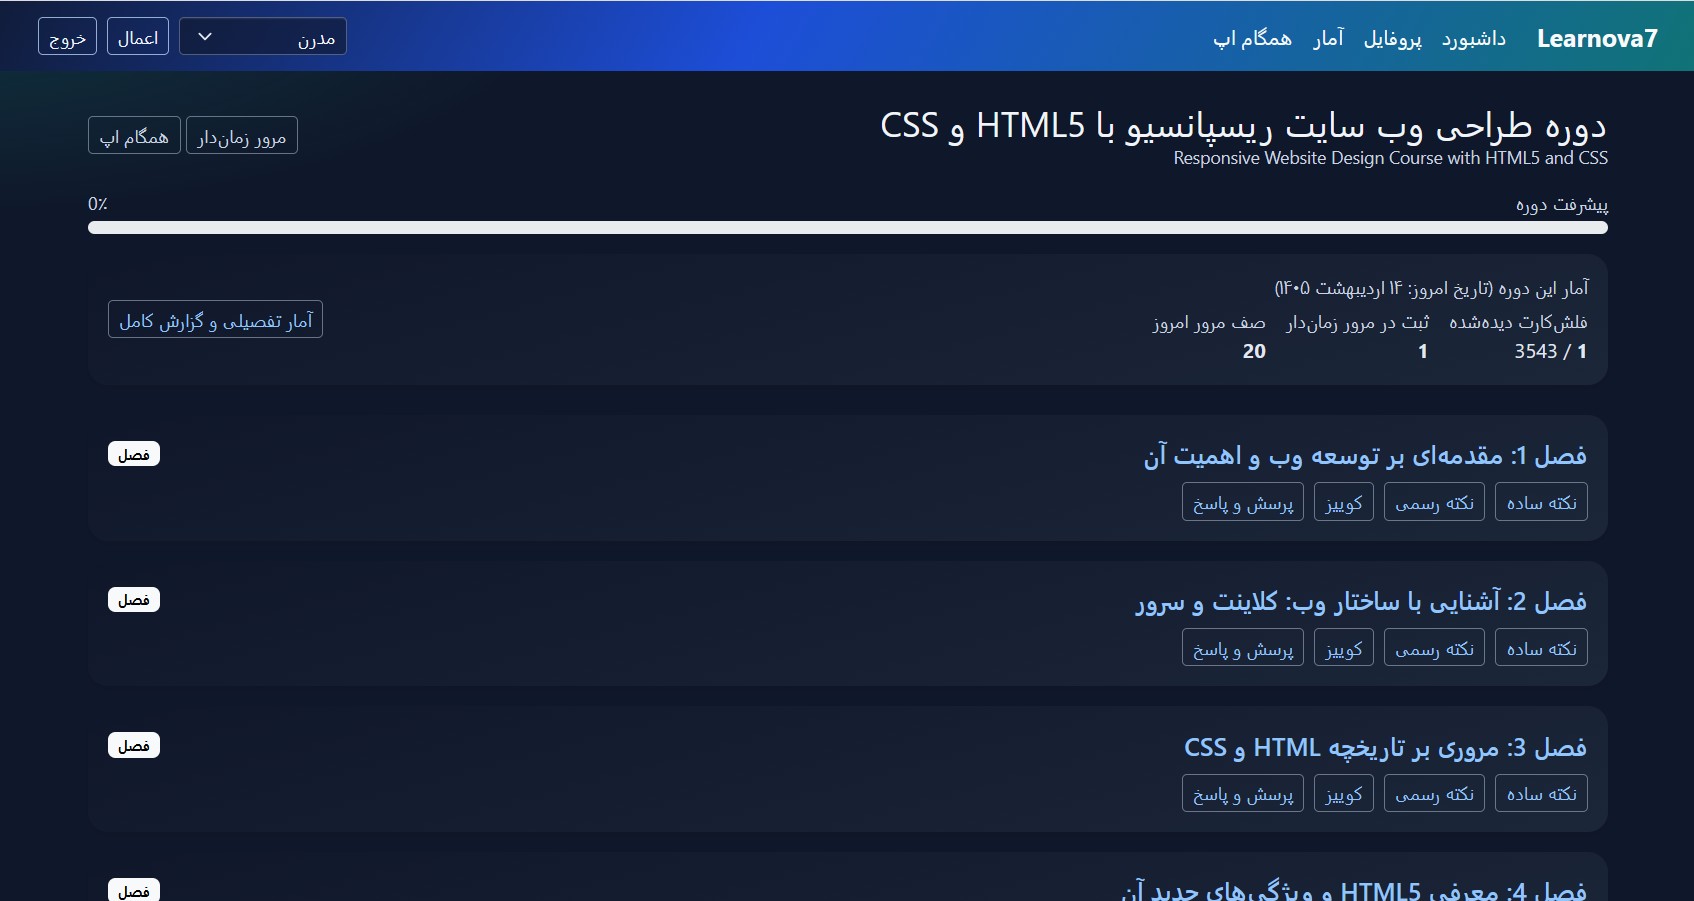
امکانات بیشتر سامانه
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
یادگیری فراتر از مطالعه معمولی
با فلشکارتهای آموزشی، مرور هدفمند و تمرین مستمر، مطالب را فعالانه یاد بگیرید و مسیر پیشرفت خود را دنبال کنید.
تگها:
data-driven decision making
Inference-Aware
Policy Optimization
reinforcement learning
RL در درمان
Winner's Curse
استنتاج آماری
بهینهسازی سیاست
بهینهسازی سیاست آگاه از استنتاج
تصمیمگیری درمانی
تصمیمگیری مبتنی بر داده
عدم قطعیت
نفرین برنده
یادگیری تقویتی
یادگیری تقویتی در درمان
نظرات
هنوز نظری ثبت نشده است.
وارد شوید تا نظر ثبت کنید.