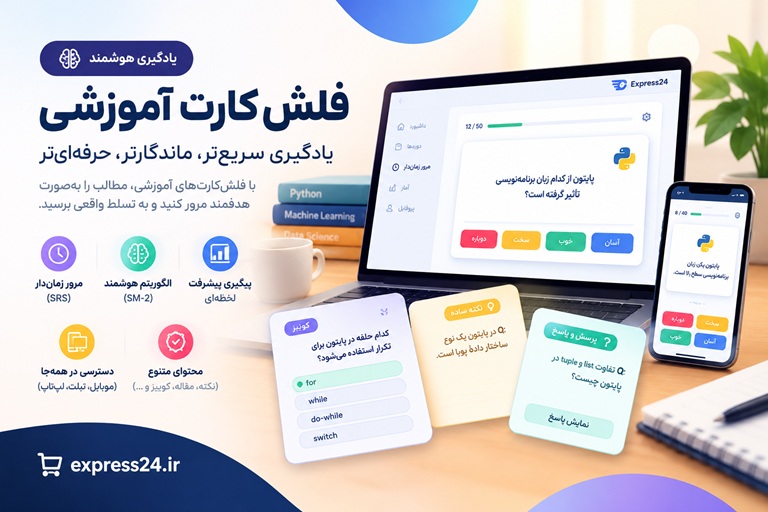
فلشکارتهای آموزشی ساخت بازی با یادگیری تقویتی
دوره جامع ساخت بازی با یادگیری تقویتی دنیای بازیها را با هوش مصنوعی تسخیر کنید! دوره جامع و پروژهمحور ساخت بازی با یادگیری تقویتی (Reinforcement Learning) معرفی دوره: از تئوری تا ساخت ایجنتهای هوشم...
🎓 دوره آموزشی جامع
📚 اطلاعات دوره
عنوان دوره: دوره ساخت بازی با یادگیری تقویتی
موضوع کلی: برنامه نویسی
موضوع میانی: یادگیری عمیق (Deep Learning)
📋 سرفصلهای دوره
- 1. معرفی دوره: ساخت بازی با یادگیری تقویتی
- 2. مروری بر اصول برنامهنویسی پایتون برای هوش مصنوعی
- 3. نصب و راهاندازی محیط توسعه (کتابخانههای NumPy, SciPy, Matplotlib)
- 4. مقدمهای بر ریاضیات یادگیری ماشین: جبر خطی کاربردی
- 5. مقدمهای بر ریاضیات یادگیری ماشین: حسابان کاربردی
- 6. مقدمهای بر ریاضیات یادگیری ماشین: آمار و احتمال
- 7. مقدمهای بر یادگیری ماشین: نظارتشده و نظارتنشده
- 8. مفاهیم پایه هوش مصنوعی در بازیها
- 9. مقدمهای بر یادگیری تقویتی: چرا و چگونه
- 10. اجزای اصلی یادگیری تقویتی: عامل، محیط، حالت، عمل، پاداش
- 11. مفهوم سیاست (Policy) و تابع ارزش (Value Function)
- 12. فرآیندهای تصمیمگیری مارکوف (MDPs)
- 13. معادلات بلومن (Bellman Equations) و کاربردها
- 14. تعادل بین اکتشاف و بهرهبرداری (Exploration vs. Exploitation)
- 15. محیطهای شبیهسازی برای یادگیری تقویتی (مثل OpenAI Gym)
- 16. برنامهریزی دینامیک: تکرار سیاست (Policy Iteration)
- 17. برنامهریزی دینامیک: تکرار ارزش (Value Iteration)
- 18. یادگیری مونت کارلو (Monte Carlo Learning) برای پیشبینی ارزش
- 19. یادگیری مونت کارلو برای کنترل: SARSA
- 20. یادگیری تفاوت زمانی (Temporal Difference Learning)
- 21. الگوریتم SARSA: On-Policy TD Control
- 22. الگوریتم Q-Learning: Off-Policy TD Control
- 23. جدول Q (Q-Table) و محدودیتهای آن
- 24. تخمین تابع ارزش با توابع پایه (Feature Engineering)
- 25. معرفی توابع تقریب ارزش (Value Function Approximation)
- 26. کدنویسی Q-Learning در یک محیط ساده (Gridworld)
- 27. Q-Learning با Epsilon-Greedy Policy
- 28. مقایسه SARSA و Q-Learning
- 29. کنترل در محیطهای پیوسته (Continuous Control) - مقدماتی
- 30. معرفی مشکل Curse of Dimensionality
- 31. مروری بر یادگیری عمیق و شبکههای عصبی
- 32. نورونهای مصنوعی و مدل پرسپترون
- 33. شبکه عصبی چند لایه (Multi-Layer Perceptron - MLP)
- 34. توابع فعالسازی (Activation Functions) و انواع آنها
- 35. تابع هزینه (Loss Function) و مفهوم بهینهسازی
- 36. گرادیان کاهشی (Gradient Descent) و انواع آن
- 37. پسانتشار (Backpropagation) و چگونگی یادگیری شبکه
- 38. بهینهسازها (Optimizers): SGD, Adam, RMSprop
- 39. معرفی کتابخانه TensorFlow/PyTorch برای یادگیری عمیق
- 40. ساخت اولین شبکه عصبی با TensorFlow/PyTorch
- 41. پردازش دادههای تصویری: معرفی شبکههای عصبی پیچشی (CNN)
- 42. لایههای پیچشی (Convolutional Layers) و پولینگ (Pooling Layers)
- 43. معماریهای رایج CNN برای بینایی ماشین
- 44. استفاده از CNN برای استخراج ویژگی از حالتهای بصری بازی
- 45. شبکههای عصبی بازگشتی (Recurrent Neural Networks - RNN) - مقدماتی
- 46. واحدهای LSTM و GRU برای حافظه بلندمدت
- 47. معماری Encoder-Decoder
- 48. تنظیم ابرپارامترها (Hyperparameter Tuning) در شبکههای عصبی
- 49. تکنیکهای رگولاریزاسیون (Regularization): Dropout, L1/L2
- 50. پیشگیری از بیشبرازش (Overfitting) و کمبرازش (Underfitting)
- 51. ترکیب یادگیری عمیق و یادگیری تقویتی: Deep RL
- 52. معرفی شبکههای Q عمیق (Deep Q-Networks - DQN)
- 53. معماری DQN برای بازیهای آتاری
- 54. تجربه بازپخش (Experience Replay) برای پایداری یادگیری
- 55. شبکههای هدف (Target Networks) برای تثبیت یادگیری
- 56. پیادهسازی DQN از ابتدا
- 57. DQN دوگانه (Double DQN) برای کاهش بیشبرآورد
- 58. DQN دوئل (Dueling DQN) برای جداسازی ارزش و برتری
- 59. بازپخش تجربه با اولویت (Prioritized Experience Replay - PER)
- 60. روشهای گرادیان سیاست (Policy Gradient Methods)
- 61. الگوریتم REINFORCE (Monte Carlo Policy Gradient)
- 62. توابع تقریب برای سیاست و ارزش (Actor-Critic Framework)
- 63. معرفی الگوریتم A2C (Advantage Actor-Critic)
- 64. معرفی الگوریتم A3C (Asynchronous Advantage Actor-Critic)
- 65. پیادهسازی A2C در یک محیط بازی ساده
- 66. مشکل ناپایداری در گرادیان سیاست
- 67. روشهای اطمینانبخش گرادیان سیاست (Trust Region Policy Optimization - TRPO) - مقدماتی
- 68. بهینهسازی سیاست پروگزیمال (Proximal Policy Optimization - PPO)
- 69. پیادهسازی PPO برای کنترل کاراکتر بازی
- 70. یادگیری تقویتی تعیینگر عمیق (Deep Deterministic Policy Gradient - DDPG)
- 71. DDPG برای فضاهای عمل پیوسته
- 72. DDPG با شبکههای هدف و بافر بازپخش
- 73. TD3 (Twin Delayed DDPG) برای بهبود پایداری DDPG
- 74. SAC (Soft Actor-Critic) برای اکتشاف بهتر و پایداری
- 75. مقایسه و انتخاب الگوریتم DRL مناسب برای سناریوهای مختلف
- 76. طراحی محیطهای بازی برای یادگیری تقویتی: اصول
- 77. تعریف حالتهای بازی (Game States) و تبدیل به ورودی شبکه
- 78. تعریف فضاهای عمل (Action Spaces) در بازیها
- 79. مهندسی پاداش (Reward Shaping): هنر تعیین پاداشها
- 80. مدلسازی محیط بازی با کتابخانه OpenAI Gym
- 81. ساخت محیط بازی سفارشی با Pygame برای RL
- 82. معرفی Unity ML-Agents برای ساخت بازی با RL
- 83. آموزش عاملهای RL در محیط Unity
- 84. یادگیری تقویتی چندعامله (Multi-Agent RL - MARL) در بازیها
- 85. چالشها در MARL: ناپایداری و تعاملات پیچیده
- 86. معرفی الگوریتمهای MARL برای بازیها (مثل MADDPG)
- 87. بازیهای همکاریگرایانه و رقابتی با MARL
- 88. بهینهسازی عملکرد عاملهای RL در بازیهای پیچیده
- 89. تکنیکهای یادگیری انتقالی (Transfer Learning) در RL برای بازیها
- 90. یادگیری از تظاهرات (Learning from Demonstrations - LfD) / Imitation Learning
- 91. استفاده از یادگیری تقویتی برای تولید محتوای رویهای (Procedural Content Generation)
- 92. ایجاد هوش مصنوعی دشمنان پویا و سازگار با RL
- 93. تست و ارزیابی عاملهای یادگیری تقویتی در بازی
- 94. معیارهای ارزیابی عملکرد عامل RL
- 95. اشکالزدایی و رفع خطاهای رایج در DRL
- 96. تنظیم پیشرفته ابرپارامترها برای DRL
- 97. موردکاوی: آموزش عامل برای بازی Flappy Bird
- 98. موردکاوی: آموزش عامل برای یک بازی استراتژیک ساده
- 99. مروری بر چالشها و روندهای آینده در ساخت بازی با RL
- 100. پروژهی نهایی: ساخت یک بازی کوچک با AI مبتنی بر DRL
SMART LEARNING PLATFORM
از مطالعه تا یادگیری ماندگار
فراتر از یک مجموعه فلشکارت؛ تجربهای تعاملی برای یادگیری، تمرین، مرور هوشمند و مشاهده مسیر پیشرفت شما، همراه با امکان دریافت گواهی پایان دوره در دورههای واجد شرایط.
مرور فاصلهدار
آمار یادگیری
گواهی دوزبانه
یادگیری را به یک مسیر قابل پیگیری تبدیل کنید
با ورود به سامانه آموزشی، محتوای دوره را بهصورت مرحلهای دنبال کنید، فلشکارتها را مرور کنید، دانش خود را با پرسشها و آزمونها بسنجید و روند پیشرفتتان را در طول مسیر ببینید.
⟳
مرور فاصلهدار هوشمند
با مرور زماندار، کارتهای تازه و کارتهای سررسیدشده را بر اساس برنامه مرور دنبال کنید. ارزیابی پاسخها به زمانبندی مرورهای بعدی کمک میکند تا تمرین متناسبتری داشته باشید.
◉
مشاهده مسیر پیشرفت
میزان مشاهده فلشکارتها، فعالیتهای مرور، عملکرد آزمونها و آمار یادگیری را بررسی کنید و تصویر روشنتری از مسیر آموزشی خود داشته باشید.
▤
یادگیری مرحلهبهمرحله
فصلها و بخشهای آموزشی را به ترتیب دنبال کنید، مطالب دیدهنشده را پیدا کنید و بدون سردرگمی به ادامه مسیر برگردید.
✓
تمرین و سنجش آموختهها
با نکتههای آموزشی، پرسش و پاسخ، کوییزها و آزمونهای پایان فصل، دانستههای خود را تمرین کنید و بخشهایی را که به توجه بیشتری نیاز دارند بشناسید.
SMART REVIEW
هر بار، مرور هدفمندتر
لازم نیست هر روز از ابتدا درباره اینکه چه چیزی را مرور کنید تصمیم بگیرید. سامانه، صف مرور روزانه را بر اساس کارتهای تازه و موعد مرور کارتها آماده میکند. شما پاسخ را ارزیابی میکنید و برنامه مرور با توجه به آن تنظیم میشود.
دوباره
برای کارتهایی که به تمرین زودتر نیاز دارند.
سخت
برای پاسخهایی که با دشواری به یاد آمدهاند.
خوب
برای پاسخهایی که بهدرستی به یاد آوردهاید.
آسان
برای کارتهایی که پاسخ آنها را بهآسانی میدانید.
برنامه مرور بر اساس ارزیابی شما تنظیم میشود؛ مرور منظم میتواند به تثبیت آموختهها کمک کند، اما بهتنهایی تضمینکننده تسلط کامل نیست.
محتوا را به شیوههای مختلف تمرین کنید
ساختار دورهها متناسب با موضوع آموزشی طراحی شده است و ممکن است انواع مختلفی از محتوا را در بر بگیرد.
نکتههای ساده
برای مرور سریع مفاهیم اصلی و نکات کلیدی.
نکتههای رسمی
برای تمرین تعاریف، اصطلاحات و بیان دقیق علمی.
کوییز
برای سنجش درک مطلب و بررسی گزینه صحیح.
پرسش و پاسخ
برای تمرین یادآوری و سنجش میزان تسلط بر مطالب.
محتوای هر دوره بر اساس ساختار و امکانات فعال همان دوره ارائه میشود.
LEARN ANYWHERE
همراه شما روی مرورگر
برای استفاده از نسخه تحت وب، کافی است با حساب کاربری خود وارد سامانه شوید. بدون نیاز به نصب یک برنامه اختصاصی، میتوانید از مرورگر سازگار روی گوشی، تبلت یا رایانه به دورههای در دسترس خود مراجعه کنید.
گوشی هوشمند
برای مطالعه در زمانهای کوتاه
تبلت و لپتاپ
برای مطالعه و مرور راحتتر
حساب کاربری شخصی
برای دسترسی به دورههای مجاز شما
COURSE COMPLETION CERTIFICATE
گواهی پایان دوره؛ ثبت دستاورد شما
در دورههایی که امکان دریافت گواهی برای آنها فعال است، میتوانید پس از تکمیل شرایط آموزشی، درخواست گواهی پایان دوره ثبت کنید.
شرایط درخواست گواهی
✓ داشتن دسترسی دارای قابلیت گواهی برای دوره مربوطه.
✓ تکمیل اطلاعات لازم در پروفایل، شامل کد ملی معتبر، عکس پرسنلی و نام و نام خانوادگی انگلیسی.
✓ مشاهده تمام فلشکارتهای فعال دوره.
✓ قبولی در آزمونهای پایان فصل، در صورت وجود آزمون برای فصلها.
فارسی و انگلیسی
پس از تأیید و انتشار، نسخههای فارسی و انگلیسی گواهی در دسترس قرار میگیرند.
استعلام آنلاین
گواهی منتشرشده دارای QR Code و لینک اختصاصی برای بررسی آنلاین اعتبار آن است.
دانلود و چاپ
پس از انتشار گواهی، امکان دریافت نسخه PDF فارسی و انگلیسی و چاپ آن فراهم است.
توجه: ثبت درخواست به معنای صدور قطعی نیست. درخواست گواهی پس از بررسی و تأیید ادمین منتشر میشود. این گواهی، گواهی پایان دوره آموزشی است و بهخودیخود معادل مدرک دانشگاهی یا مدرک رسمی مورد تأیید نهادهای دولتی نیست.
یادگیری را شروع کنید؛ پیشرفت را دنبال کنید
با تمرین منظم، مرور هدفمند و پیگیری مسیر آموزشی خود، قدمبهقدم دانش و مهارتهایتان را گسترش دهید.
هر کارت، یک قدم به جلو
امکانات محتوایی، مرور و گواهی بر اساس سطح دسترسی و تنظیمات هر دوره متفاوت است.
نگاهی به محیط سامانه
یادگیری هوشمند، قدمبهقدم
با محیط سامانه آموزشی آشنا شوید و نمونههایی از فضای یادگیری، فلشکارتها و ابزارهای مرور و تمرین را مشاهده کنید.
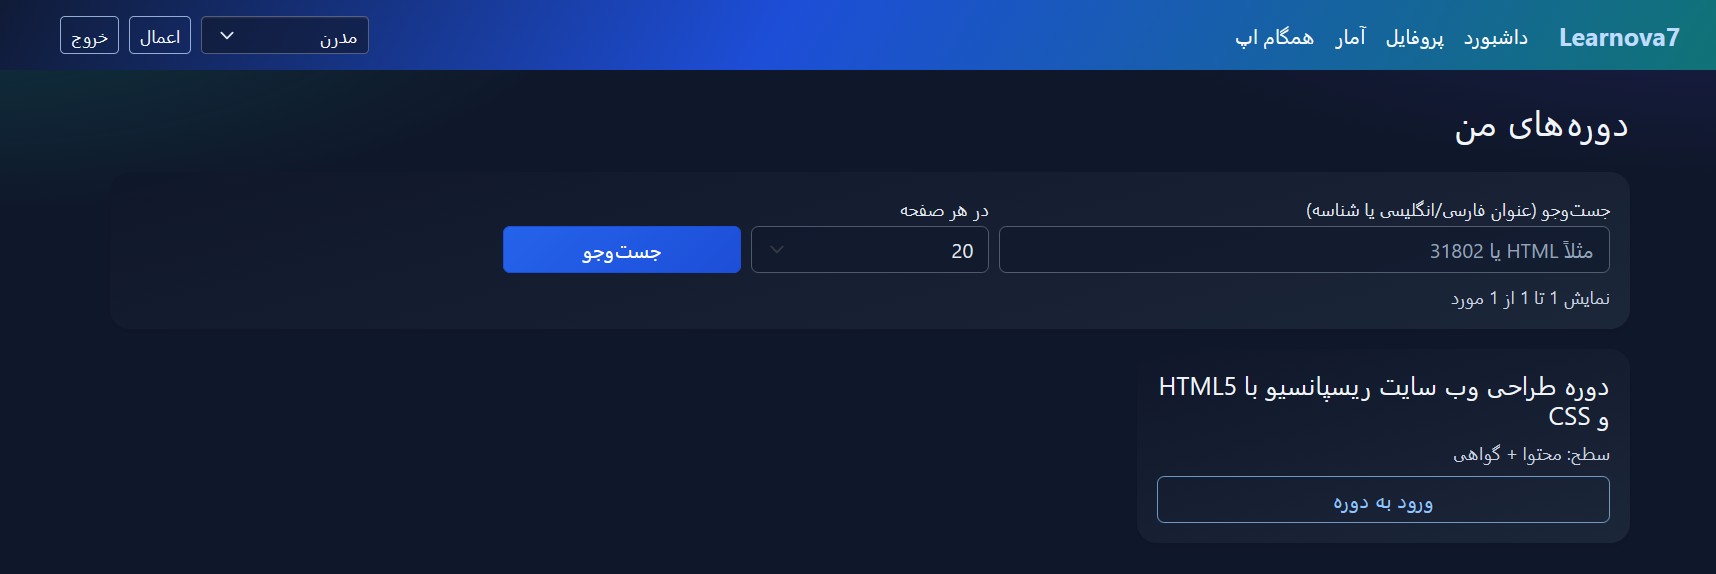
محیط سامانه آموزشی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
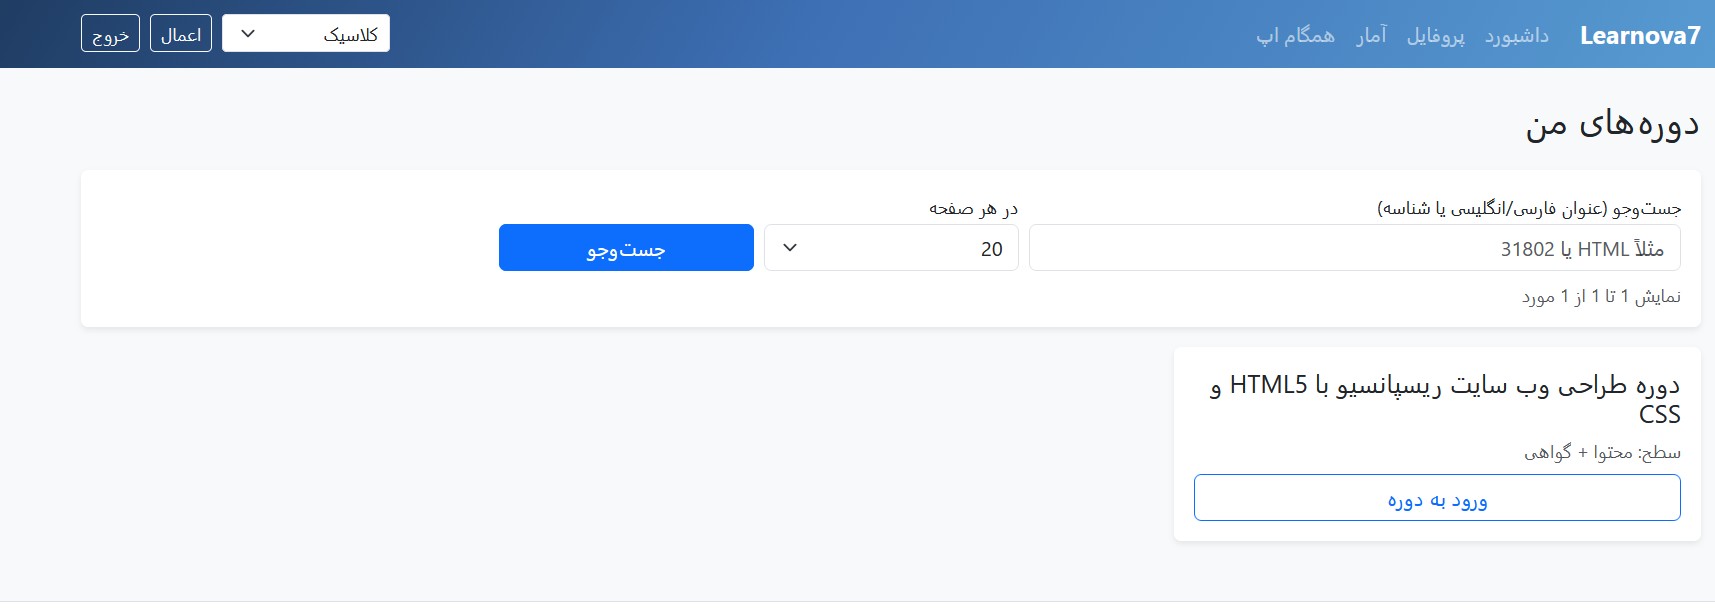
یادگیری و مرور مطالب
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
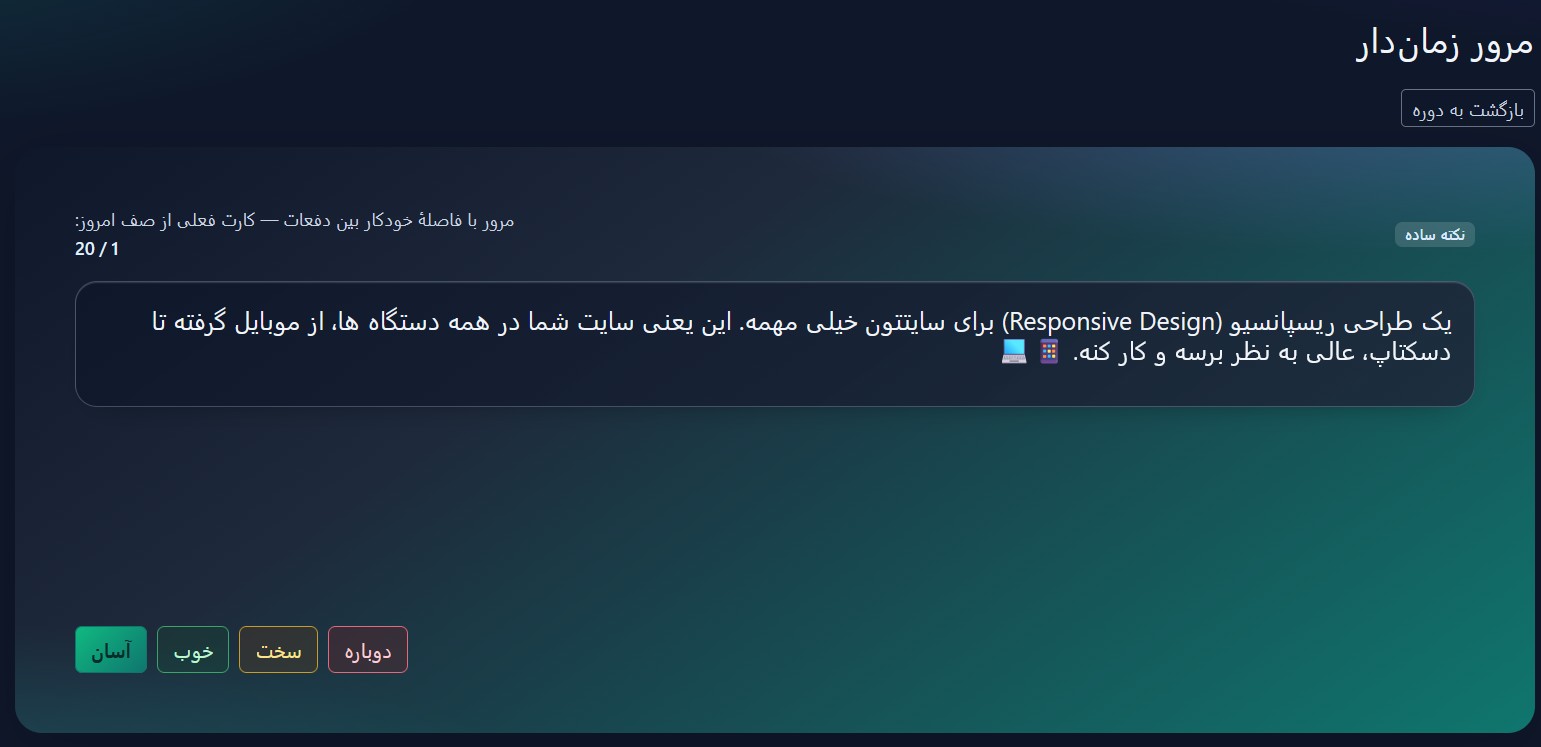
تجربه مطالعه تعاملی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
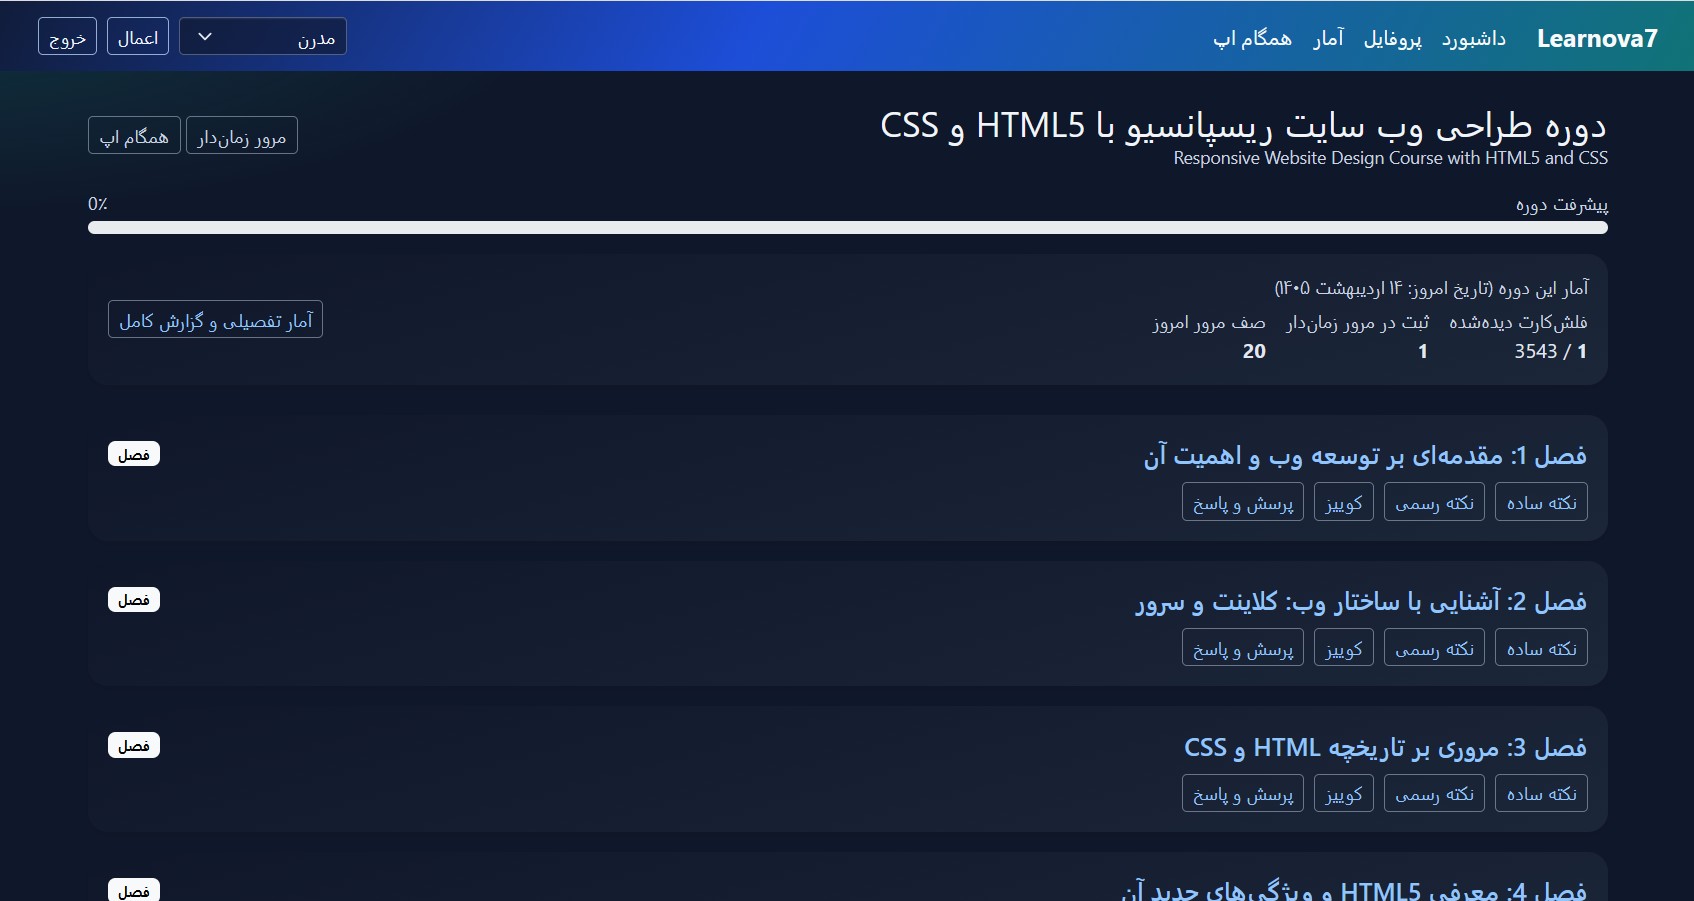
امکانات بیشتر سامانه
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
یادگیری فراتر از مطالعه معمولی
با فلشکارتهای آموزشی، مرور هدفمند و تمرین مستمر، مطالب را فعالانه یاد بگیرید و مسیر پیشرفت خود را دنبال کنید.
تگها:
AI game development
Deep Learning
Python
reinforcement learning
آموزش بازی سازی
بازی با هوش مصنوعی
بازی سازی
برنامه نویسی
برنامه نویسی هوش مصنوعی
پایتون
ساخت بازی
کدنویسی بازی
هوش مصنوعی
یادگیری تقویتی
یادگیری عمیق
نظرات
هنوز نظری ثبت نشده است.
وارد شوید تا نظر ثبت کنید.