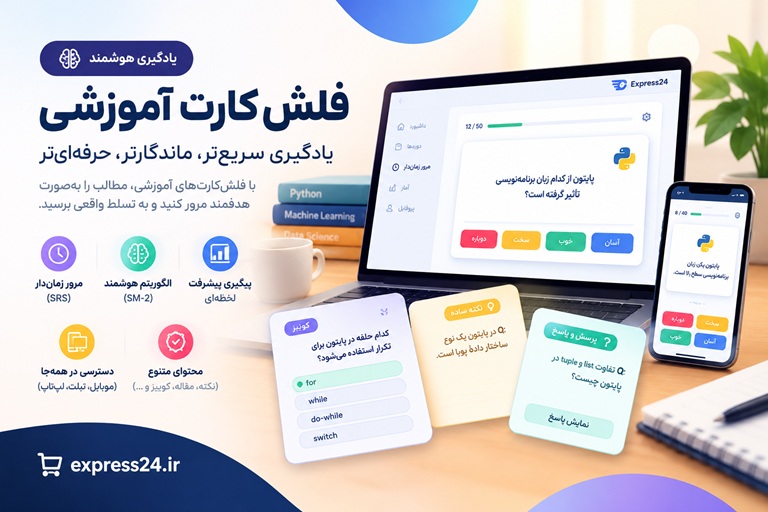
فلشکارتهای آموزشی بهینهسازی الگوریتمهای پردازش سیگنال برای سرعت
بهینهسازی الگوریتمهای پردازش سیگنال برای سرعت - گامی بلند در دنیای HPC! بهینهسازی الگوریتمهای پردازش سیگنال برای سرعت: قدرت را در دستان خود حس کنید! آیا به دنبال ارتقای مهارتهای برنامهنویسی خود ...
🎓 دوره آموزشی جامع
📚 اطلاعات دوره
عنوان دوره: دوره بهینهسازی الگوریتمهای پردازش سیگنال برای سرعت
موضوع کلی: برنامه نویسی
موضوع میانی: محاسبات سطح بالا (High-Performance Computing)
📋 سرفصلهای دوره
- 1. بخش اول: مبانی و اصول اولیه**
- 2. مقدمهای بر محاسبات سطح بالا در پردازش سیگنال
- 3. مروری بر مفاهیم پایه پردازش سیگنال دیجیتال (DSP)
- 4. سیگنالهای گسسته در زمان و تبدیل فوریه گسسته (DFT)
- 5. مفهوم کانولوشن، همبستگی و فیلترهای دیجیتال (FIR و IIR)
- 6. تحلیل پیچیدگی الگوریتمها: نماد O بزرگ و اهمیت آن در عملکرد
- 7. معیارهای اندازهگیری عملکرد: سرعت، توان عملیاتی و تاخیر
- 8. اصول بنچمارکینگ: نحوه اندازهگیری دقیق زمان اجرا
- 9. آشنایی با ابزارهای اولیه پروفایلبندی برای شناسایی گلوگاهها
- 10. معماری پردازندههای مدرن (CPU): خط لوله (Pipelining) و اجرای خارج از نوبت
- 11. سلسله مراتب حافظه: رجیستر، کش (L1, L2, L3)، حافظه اصلی و دیسک
- 12. تاثیر سلسله مراتب حافظه بر عملکرد الگوریتمها
- 13. مفهوم تنگنا (Bottleneck) در عملکرد: CPU-bound در مقابل Memory-bound
- 14. بخش دوم: بهینهسازی تک هستهای (Single-Core Optimization)**
- 15. نقش کامپایلر در بهینهسازی کد
- 16. پرچمهای بهینهسازی کامپایلر (مانند -O1, -O2, -O3, -Ofast)
- 17. تحلیل کد اسمبلی تولید شده توسط کامپایلر
- 18. درونخطی کردن توابع (Function Inlining) و باز کردن حلقهها (Loop Unrolling)
- 19. بهینهسازیهای مبتنی بر پروفایل (Profile-Guided Optimization - PGO)
- 20. تاثیر ساختارهای داده بر عملکرد: آرایهها، لیستهای پیوندی و درختها
- 21. چیدمان داده در حافظه: ساختاری از آرایهها (SoA) در مقابل آرایهای از ساختارها (AoS)
- 22. همجواری دادهها (Data Locality): همجواری زمانی و مکانی
- 23. بهینهسازی دسترسی به حافظه برای کاهش خطاهای کش (Cache Miss)
- 24. تکنیک قطعهبندی حلقهها (Loop Tiling/Blocking) برای بهینهسازی کش
- 25. پیشواکشی داده (Data Prefetching): خودکار و دستی
- 26. بهینهسازی پیشبینی انشعاب (Branch Prediction)
- 27. کاهش قدرت عملیات (Strength Reduction) و حذف محاسبات زائد
- 28. حذف محاسبات تکراری در حلقهها (Loop-invariant code motion)
- 29. از DFT به FFT: بهینهسازی الگوریتمی تبدیل فوریه
- 30. الگوریتمهای رایج FFT: Radix-2 و Split-radix
- 31. کانولوشن سریع با استفاده از FFT (روشهای Overlap-Add و Overlap-Save)
- 32. مقدمهای بر موازیسازی در سطح دستورالعمل (Instruction-Level Parallelism - ILP)
- 33. مفهوم SIMD: یک دستور، چند داده (Single Instruction, Multiple Data)
- 34. معماریهای SIMD در پردازندههای مدرن: SSE, AVX, NEON
- 35. وکتورسازی خودکار (Auto-vectorization) توسط کامپایلر
- 36. استفاده از توابع ذاتی (Intrinsics) برای برنامهنویسی صریح SIMD
- 37. پیادهسازی یک فیلتر FIR با استفاده از دستورات ذاتی AVX
- 38. چالشهای برنامهنویسی SIMD: تراز بندی حافظه (Memory Alignment)
- 39. مدیریت دادههای باقیمانده در حلقههای وکتوریزه شده
- 40. بخش سوم: برنامهنویسی موازی روی CPU چند هستهای**
- 41. مقدمهای بر محاسبات موازی و لزوم آن
- 42. قانون امدال (Amdahl's Law) و محدودیتهای افزایش سرعت
- 43. قانون گوستافسون (Gustafson's Law) و محاسبات مقیاسپذیر
- 44. مدلهای برنامهنویسی موازی: حافظه مشترک و حافظه توزیعشده
- 45. آشنایی با نخها (Threads) و فرآیندها (Processes)
- 46. مدل حافظه مشترک و چالشهای آن: شرایط رقابتی (Race Conditions)
- 47. مفاهیم همگامسازی: انحصار متقابل (Mutex) و قفلها (Locks)
- 48. استفاده از سمافورها و متغیرهای شرطی
- 49. عملیات اتمی (Atomic Operations) برای همگامسازی سبک و کارآمد
- 50. معرفی OpenMP: مدلی ساده برای برنامهنویسی موازی با حافظه مشترک
- 51. ساختارهای موازیسازی حلقهها در OpenMP (parallel for)
- 52. مدیریت حوزه متغیرها در OpenMP: private, shared, reduction
- 53. زمانبندی حلقهها در OpenMP: static, dynamic, guided
- 54. موازیسازی وظایف (Task Parallelism) با OpenMP
- 55. همگامسازی در OpenMP: critical, barrier, atomic
- 56. بهینهسازی یک حلقه کانولوشن با استفاده از OpenMP
- 57. پیادهسازی موازی FFT بر روی CPU چند هستهای با OpenMP
- 58. مشکل اشتراک کاذب (False Sharing) و راههای شناسایی و مقابله با آن
- 59. معماریهای NUMA و تاثیر آن بر عملکرد برنامههای موازی
- 60. آشنایی با کتابخانههای پردازش سیگنال چندنخی (مانند Intel MKL, FFTW)
- 61. بخش چهارم: برنامهنویسی شتابدهندهها و GPU**
- 62. مقدمهای بر معماری GPU: تفاوت بنیادین با CPU
- 63. مدل برنامهنویسی CUDA: میزبان (Host) و دستگاه (Device)
- 64. سلسله مراتب نخها در CUDA: Grid, Block, Thread
- 65. نوشتن، کامپایل و اجرای اولین کرنل (Kernel) در CUDA
- 66. مدیریت حافظه در CUDA: تخصیص و کپی داده بین میزبان و دستگاه
- 67. سلسله مراتب حافظه در GPU: Global, Shared, Constant, Local, Texture
- 68. مفهوم Warp و اجرای SIMT (Single Instruction, Multiple Threads)
- 69. اهمیت حافظه مشترک (Shared Memory) برای بهینهسازی ارتباط بین نخها
- 70. پیادهسازی بهینه کانولوشن روی GPU با استفاده از حافظه مشترک
- 71. دسترسی ادغامشده به حافظه سراسری (Coalesced Memory Access)
- 72. واگرایی نخها (Thread Divergence) و تاثیر منفی آن بر عملکرد
- 73. پروفایلبندی برنامههای CUDA با استفاده از Nsight Systems/Compute
- 74. معرفی کتابخانه cuFFT برای تبدیل فوریه سریع روی GPU
- 75. استفاده از cuFFT برای پیادهسازی فیلترینگ در حوزه فرکانس
- 76. کتابخانههای دیگر CUDA برای پردازش سیگنال (cuBLAS, Thrust)
- 77. اجرای همزمان کرنلها و انتقال داده با CUDA Streams
- 78. استفاده از حافظه الصاقشده (Pinned Memory) برای انتقال سریعتر داده
- 79. عملیات اتمی در GPU برای همگامسازی بین نخها
- 80. الگوی کاهش (Reduction) موازی بر روی GPU
- 81. مقدمهای بر OpenCL به عنوان یک جایگزین چندسکویی برای CUDA
- 82. مقایسه مدل برنامهنویسی و عملکرد CUDA و OpenCL
- 83. مطالعه موردی: پیادهسازی یک آشکارساز همبستگی (Correlator) روی GPU
- 84. بخش پنجم: موضوعات پیشرفته و مطالعات موردی**
- 85. برنامهنویسی ترکیبی (Hybrid): استفاده همزمان از CPU (OpenMP) و GPU (CUDA)
- 86. مدل برنامهنویسی MPI برای کلاسترهای محاسباتی (مقدماتی)
- 87. بهینهسازی ورودی/خروجی (I/O): خواندن و نوشتن سریع دادههای حجیم سیگنال
- 88. فرمتهای داده بهینه برای پردازشهای سطح بالا (مانند HDF5, Parquet)
- 89. استفاده از کتابخانههای سطح بالای بهینهشده: Intel IPP و Arm Performance Libraries
- 90. مطالعه موردی ۱: بهینهسازی یک خط لوله پردازش صوتی بیدرنگ
- 91. مطالعه موردی ۲: تسریع الگوریتمهای شکلدهی پرتو (Beamforming)
- 92. مطالعه موردی ۳: بهینهسازی پردازش تصویر رادار با دیافراگم مصنوعی (SAR)
- 93. مطالعه موردی ۴: پیادهسازی یک مودم رادیو نرمافزاری (SDR) بهینه
- 94. دیباگ کردن کدهای موازی: چالشها و ابزارها (CUDA-GDB, GDB for threads)
- 95. بهینهسازی برای معماریهای سختافزاری خاص (CPU/GPU-specific tuning)
- 96. آشنایی با شتابدهندههای دیگر: FPGA و نقش آنها در پردازش سیگنال
- 97. نگاهی به آینده: یادگیری ماشین و هوش مصنوعی در بهینهسازی الگوریتمها
- 98. مدیریت وابستگیها و ساخت پروژههای HPC با ابزارهایی مانند CMake
- 99. جمعبندی تکنیکهای بهینهسازی: یک چکلیست جامع برای توسعهدهندگان
- 100. پروژه نهایی: بهینهسازی یک الگوریتم جامع پردازش سیگنال از ابتدا تا انتها
SMART LEARNING PLATFORM
از مطالعه تا یادگیری ماندگار
فراتر از یک مجموعه فلشکارت؛ تجربهای تعاملی برای یادگیری، تمرین، مرور هوشمند و مشاهده مسیر پیشرفت شما، همراه با امکان دریافت گواهی پایان دوره در دورههای واجد شرایط.
مرور فاصلهدار
آمار یادگیری
گواهی دوزبانه
یادگیری را به یک مسیر قابل پیگیری تبدیل کنید
با ورود به سامانه آموزشی، محتوای دوره را بهصورت مرحلهای دنبال کنید، فلشکارتها را مرور کنید، دانش خود را با پرسشها و آزمونها بسنجید و روند پیشرفتتان را در طول مسیر ببینید.
⟳
مرور فاصلهدار هوشمند
با مرور زماندار، کارتهای تازه و کارتهای سررسیدشده را بر اساس برنامه مرور دنبال کنید. ارزیابی پاسخها به زمانبندی مرورهای بعدی کمک میکند تا تمرین متناسبتری داشته باشید.
◉
مشاهده مسیر پیشرفت
میزان مشاهده فلشکارتها، فعالیتهای مرور، عملکرد آزمونها و آمار یادگیری را بررسی کنید و تصویر روشنتری از مسیر آموزشی خود داشته باشید.
▤
یادگیری مرحلهبهمرحله
فصلها و بخشهای آموزشی را به ترتیب دنبال کنید، مطالب دیدهنشده را پیدا کنید و بدون سردرگمی به ادامه مسیر برگردید.
✓
تمرین و سنجش آموختهها
با نکتههای آموزشی، پرسش و پاسخ، کوییزها و آزمونهای پایان فصل، دانستههای خود را تمرین کنید و بخشهایی را که به توجه بیشتری نیاز دارند بشناسید.
SMART REVIEW
هر بار، مرور هدفمندتر
لازم نیست هر روز از ابتدا درباره اینکه چه چیزی را مرور کنید تصمیم بگیرید. سامانه، صف مرور روزانه را بر اساس کارتهای تازه و موعد مرور کارتها آماده میکند. شما پاسخ را ارزیابی میکنید و برنامه مرور با توجه به آن تنظیم میشود.
دوباره
برای کارتهایی که به تمرین زودتر نیاز دارند.
سخت
برای پاسخهایی که با دشواری به یاد آمدهاند.
خوب
برای پاسخهایی که بهدرستی به یاد آوردهاید.
آسان
برای کارتهایی که پاسخ آنها را بهآسانی میدانید.
برنامه مرور بر اساس ارزیابی شما تنظیم میشود؛ مرور منظم میتواند به تثبیت آموختهها کمک کند، اما بهتنهایی تضمینکننده تسلط کامل نیست.
محتوا را به شیوههای مختلف تمرین کنید
ساختار دورهها متناسب با موضوع آموزشی طراحی شده است و ممکن است انواع مختلفی از محتوا را در بر بگیرد.
نکتههای ساده
برای مرور سریع مفاهیم اصلی و نکات کلیدی.
نکتههای رسمی
برای تمرین تعاریف، اصطلاحات و بیان دقیق علمی.
کوییز
برای سنجش درک مطلب و بررسی گزینه صحیح.
پرسش و پاسخ
برای تمرین یادآوری و سنجش میزان تسلط بر مطالب.
محتوای هر دوره بر اساس ساختار و امکانات فعال همان دوره ارائه میشود.
LEARN ANYWHERE
همراه شما روی مرورگر
برای استفاده از نسخه تحت وب، کافی است با حساب کاربری خود وارد سامانه شوید. بدون نیاز به نصب یک برنامه اختصاصی، میتوانید از مرورگر سازگار روی گوشی، تبلت یا رایانه به دورههای در دسترس خود مراجعه کنید.
گوشی هوشمند
برای مطالعه در زمانهای کوتاه
تبلت و لپتاپ
برای مطالعه و مرور راحتتر
حساب کاربری شخصی
برای دسترسی به دورههای مجاز شما
COURSE COMPLETION CERTIFICATE
گواهی پایان دوره؛ ثبت دستاورد شما
در دورههایی که امکان دریافت گواهی برای آنها فعال است، میتوانید پس از تکمیل شرایط آموزشی، درخواست گواهی پایان دوره ثبت کنید.
شرایط درخواست گواهی
✓ داشتن دسترسی دارای قابلیت گواهی برای دوره مربوطه.
✓ تکمیل اطلاعات لازم در پروفایل، شامل کد ملی معتبر، عکس پرسنلی و نام و نام خانوادگی انگلیسی.
✓ مشاهده تمام فلشکارتهای فعال دوره.
✓ قبولی در آزمونهای پایان فصل، در صورت وجود آزمون برای فصلها.
فارسی و انگلیسی
پس از تأیید و انتشار، نسخههای فارسی و انگلیسی گواهی در دسترس قرار میگیرند.
استعلام آنلاین
گواهی منتشرشده دارای QR Code و لینک اختصاصی برای بررسی آنلاین اعتبار آن است.
دانلود و چاپ
پس از انتشار گواهی، امکان دریافت نسخه PDF فارسی و انگلیسی و چاپ آن فراهم است.
توجه: ثبت درخواست به معنای صدور قطعی نیست. درخواست گواهی پس از بررسی و تأیید ادمین منتشر میشود. این گواهی، گواهی پایان دوره آموزشی است و بهخودیخود معادل مدرک دانشگاهی یا مدرک رسمی مورد تأیید نهادهای دولتی نیست.
یادگیری را شروع کنید؛ پیشرفت را دنبال کنید
با تمرین منظم، مرور هدفمند و پیگیری مسیر آموزشی خود، قدمبهقدم دانش و مهارتهایتان را گسترش دهید.
هر کارت، یک قدم به جلو
امکانات محتوایی، مرور و گواهی بر اساس سطح دسترسی و تنظیمات هر دوره متفاوت است.
نگاهی به محیط سامانه
یادگیری هوشمند، قدمبهقدم
با محیط سامانه آموزشی آشنا شوید و نمونههایی از فضای یادگیری، فلشکارتها و ابزارهای مرور و تمرین را مشاهده کنید.
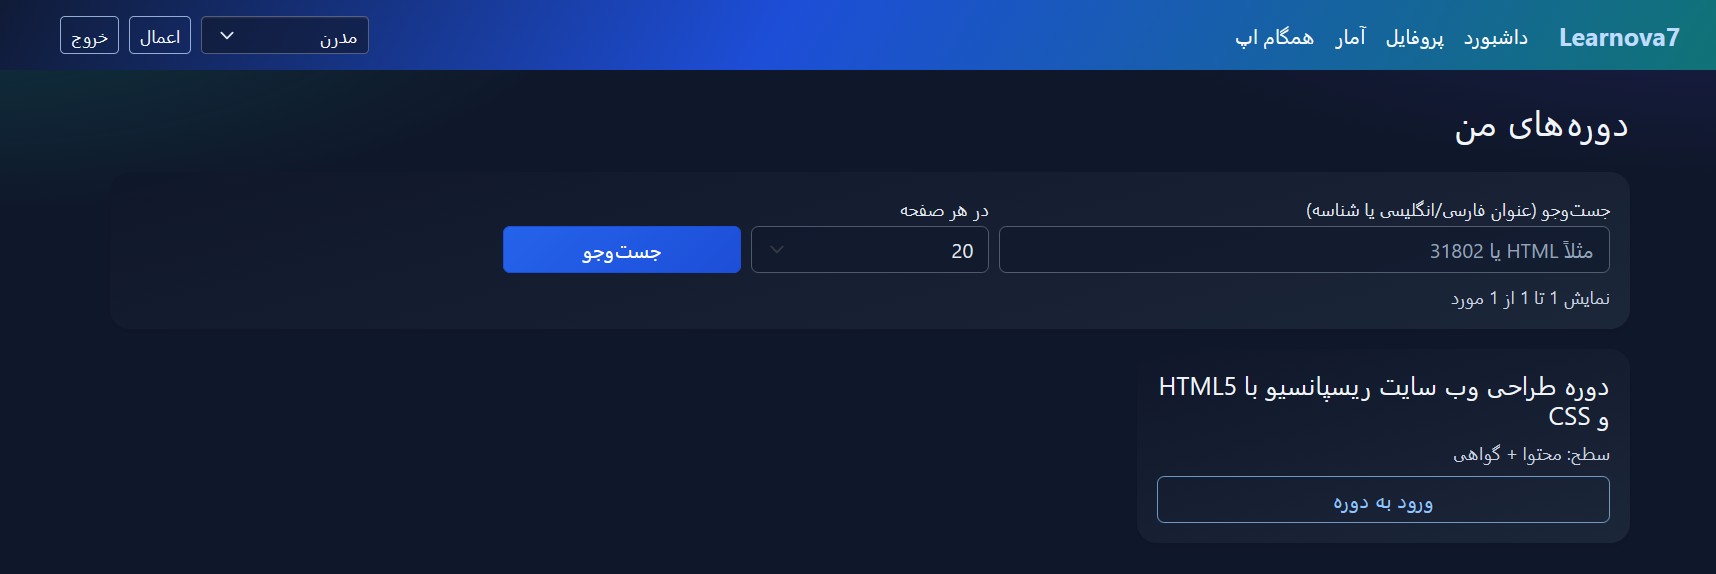
محیط سامانه آموزشی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
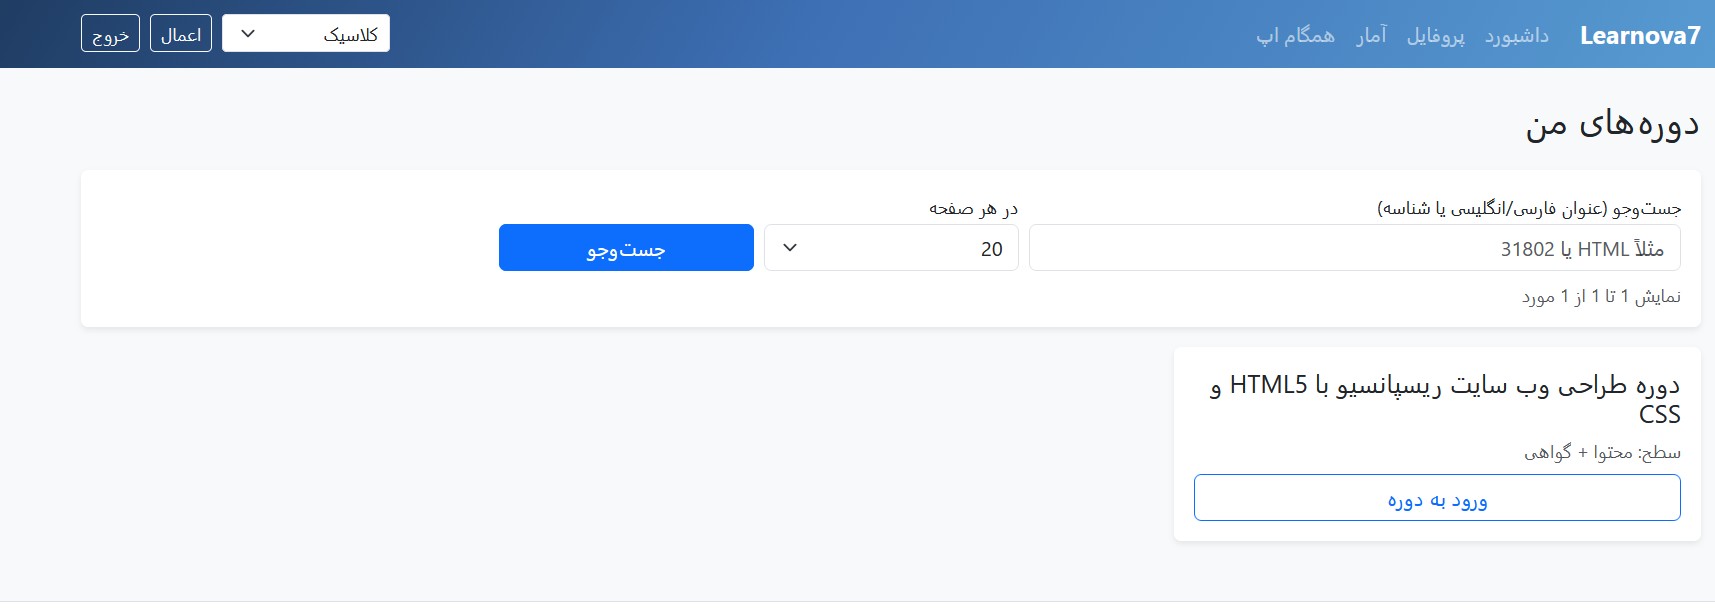
یادگیری و مرور مطالب
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
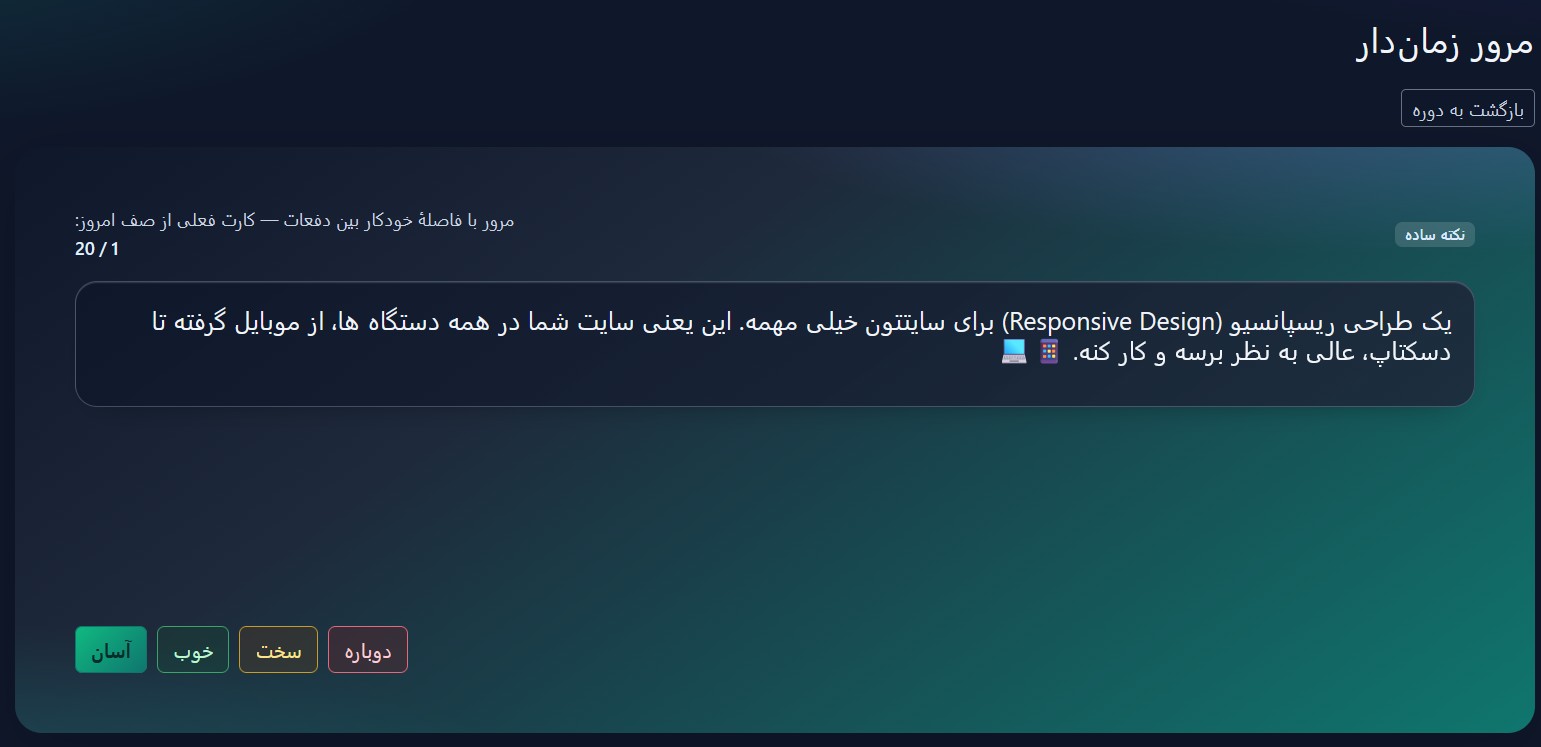
تجربه مطالعه تعاملی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
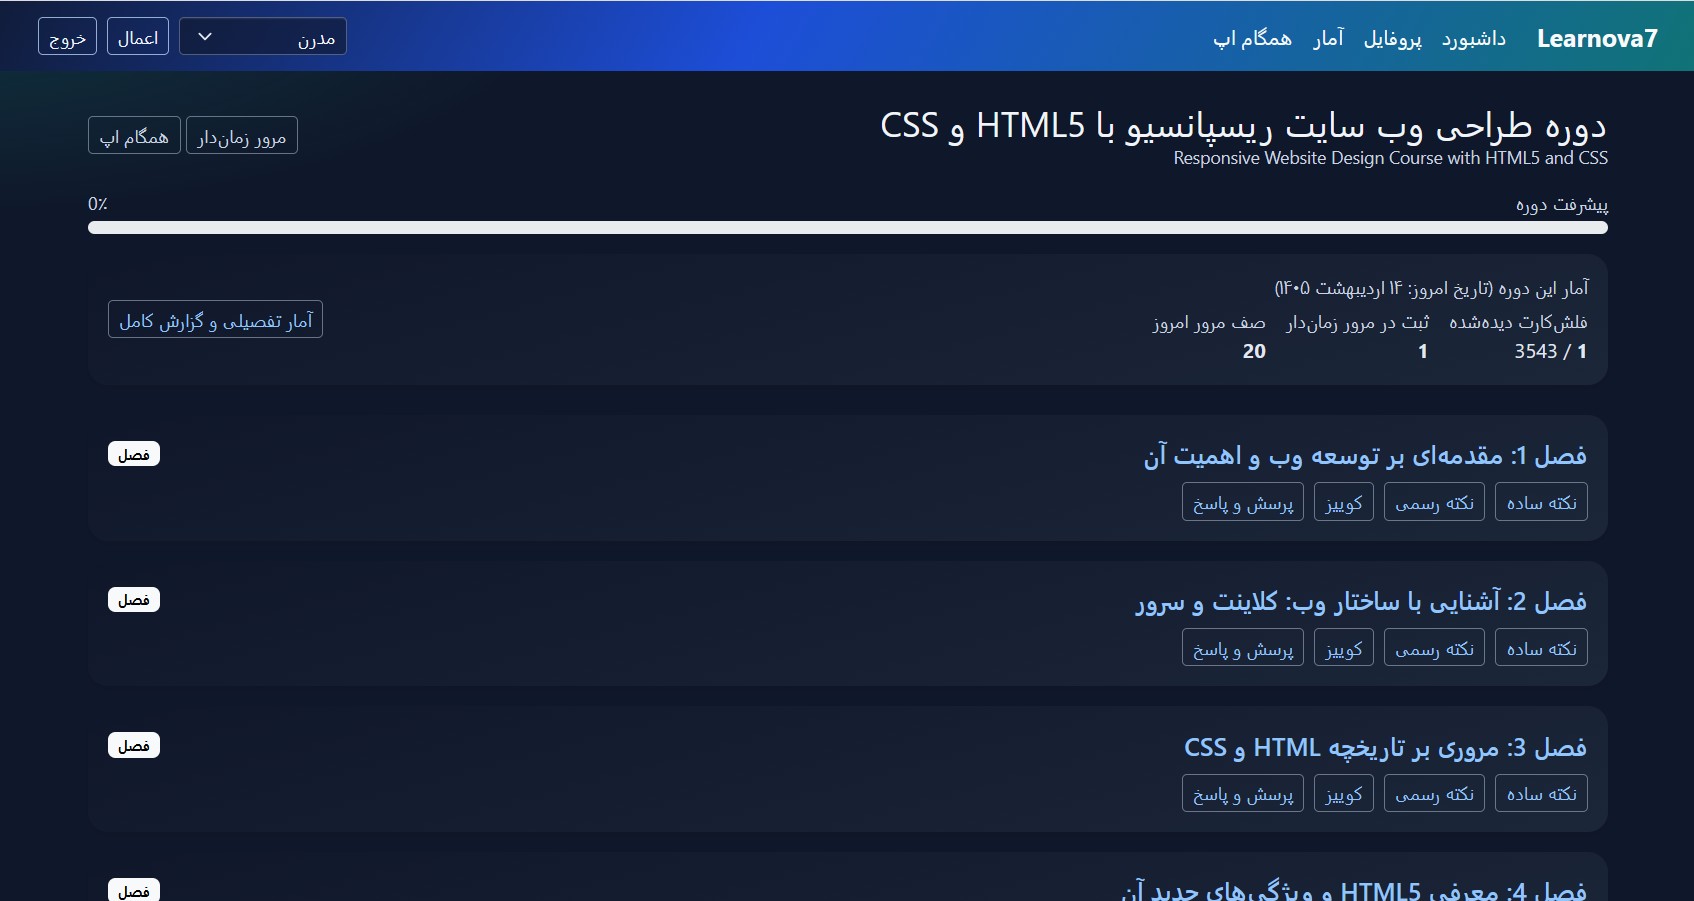
امکانات بیشتر سامانه
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
یادگیری فراتر از مطالعه معمولی
با فلشکارتهای آموزشی، مرور هدفمند و تمرین مستمر، مطالب را فعالانه یاد بگیرید و مسیر پیشرفت خود را دنبال کنید.
تگها:
Fast Algorithms
High-Performance Computing
HPC
Parallel Computing
Signal Processing Optimization
الگوریتم
برنامه نویسی
برنامهنویسی
بهینهسازی الگوریتم
بهینهسازی کد
پردازش سیگنال
سرعت
سیگنال
کدنویسی
محاسبات سطح بالا
نظرات
هنوز نظری ثبت نشده است.
وارد شوید تا نظر ثبت کنید.