فلشکارتهای آموزشی بهینهسازی اجرای مدلهای DL بر روی GPU
دوره جامع بهینهسازی اجرای مدلهای DL بر روی GPU انقلابی در سرعت: مدلهای یادگیری عمیق خود را ۱۰۰ برابر سریعتر کنید! آیا از ساعتها و روزها انتظار برای آموزش مدلهای یادگیری عمیق خود خسته شدهاید؟ آی...
🎓 دوره آموزشی جامع
📚 اطلاعات دوره
عنوان دوره: دوره بهینهسازی اجرای مدلهای DL بر روی GPU
موضوع کلی: برنامه نویسی
موضوع میانی: محاسبات سطح بالا (High-Performance Computing)
📋 سرفصلهای دوره
- 1. مقدمهای بر یادگیری عمیق و شبکههای عصبی
- 2. مروری بر معماریهای اصلی شبکههای عصبی
- 3. مفهوم Tensor و عملیات پایه
- 4. آشنایی با سختافزار GPU و تفاوت آن با CPU
- 5. مقدمهای بر محاسبات موازی
- 6. مفهوم حافظه سلسلهمراتبی (Memory Hierarchy) در CPU و GPU
- 7. نقش GPU در سرعتبخشیدن به آموزش و استنتاج مدلهای DL
- 8. معرفی ابزارهای اصلی برای برنامهنویسی GPU (CUDA/OpenCL)
- 9. معرفی فریمورکهای یادگیری عمیق (PyTorch, TensorFlow)
- 10. چالشهای بهینهسازی مدلهای DL بر روی GPU
- 11. جزئیات معماری داخلی GPU (SMs, Cores)
- 12. مفهوم Warp و Thread در GPU
- 13. مدل برنامهنویسی CUDA: هاست (Host) و دیوایس (Device)
- 14. ساختار سلسلهمراتبی Threadها (Grid, Block, Thread)
- 15. نحوه نگارش اولین کرنل (Kernel) CUDA
- 16. انتقال داده بین CPU و GPU (cudaMemcpy)
- 17. مدیریت حافظه در CUDA (cudaMalloc, cudaFree)
- 18. مفهوم کرنل و فراخوانی آن
- 19. همگامسازی (Synchronization) در CUDA (cudaDeviceSynchronize, __syncthreads)
- 20. کنترل خطا و دیباگینگ در برنامههای CUDA
- 21. انواع حافظه در GPU: سراسری (Global), مشترک (Shared), محلی (Local)
- 22. حافظه ثابت (Constant Memory) و حافظه بافت (Texture Memory)
- 23. بهینهسازی دسترسی به حافظه سراسری (Memory Coalescing)
- 24. استفاده بهینه از حافظه مشترک (Shared Memory) برای کاهش دسترسی به Global Memory
- 25. تکنیکهای کاهش Bank Conflict در Shared Memory
- 26. مدیریت حافظه مجازی و Unified Memory در CUDA
- 27. استفاده از حافظههای Pin-Memory (Page-locked Host Memory)
- 28. انتقال ناهمزمان داده (Asynchronous Data Transfer) با Streamها
- 29. مفهوم رویدادها (Events) برای زمانبندی و همگامسازی در Streamها
- 30. تاثیر پهنای باند حافظه (Memory Bandwidth) بر عملکرد
- 31. بهینهسازی استفاده از رجیسترها و جلوگیری از Register Spill
- 32. پنهانسازی تاخیر (Latency Hiding) با افزایش Occupancy
- 33. مفهوم و تاثیر Warp Divergence بر عملکرد
- 34. تکنیکهای کاهش Warp Divergence
- 35. عملیات اتمیک (Atomic Operations) و کاربرد آنها
- 36. پیادهسازی عملیات Reduction بر روی GPU
- 37. پیادهسازی Parallel Prefix Sum (Scan)
- 38. بهینهسازی Matrix Multiplication (GEMM) با CUDA
- 39. استفاده از __CUDA_ARCH__ برای کدنویسی ویژه معماری
- 40. دستورالعملهای Intrinsics برای بهینهسازیهای سطح پایین
- 41. استفاده از Dynamic Parallelism (Kernels launching Kernels)
- 42. تکنیکهای Loop Unrolling و Software Pipelining
- 43. بهینهسازی دسترسی به داده (Data Locality)
- 44. استفاده از شتابدهندههای سختافزاری (Tensor Cores در NVIDIA GPUs)
- 45. بررسی تاثیر Cache L1/L2 بر عملکرد Kernel
- 46. آشنایی با نحوه استفاده فریمورکها از GPU
- 47. مدلسازی Tensorها در PyTorch و TensorFlow برای GPU
- 48. مفهوم گراف محاسباتی (Computational Graph) و اجرای آن بر روی GPU
- 49. مشتقگیری خودکار (Autograd) و نقش آن در بهینهسازی GPU
- 50. استفاده از API فریمورکها برای عملیات GPU (e.g., .to('cuda'), tf.device('/GPU:0'))
- 51. معرفی CuDNN و CuBLAS: کتابخانههای بهینهشده برای DL بر روی GPU
- 52. تفاوت بین نسخههای مختلف CUDA/CuDNN و تاثیر آن
- 53. پیادهسازی کرنلهای CUDA سفارشی (Custom CUDA Kernels) در PyTorch
- 54. پیادهسازی کرنلهای CUDA سفارشی در TensorFlow
- 55. مدیریت حافظه GPU توسط فریمورکها
- 56. بهینهسازی عملیات I/O و پیشپردازش داده برای GPU
- 57. استفاده از Dataloaders موازی برای تغذیه سریعتر GPU
- 58. استراتژیهای بهینهسازی حافظه در فریمورکها
- 59. بررسی مصرف حافظه GPU توسط لایههای مختلف مدل
- 60. ابزارهای پروفایلینگ حافظه در فریمورکها (e.g., PyTorch Memory Profiler)
- 61. معرفی ابزارهای پروفایلینگ GPU (NVIDIA Nsight Systems, Nsight Compute)
- 62. تحلیل خروجی پروفایلر برای شناسایی گلوگاهها
- 63. تفکیک زمان مصرفی بین CPU و GPU
- 64. شناسایی عملیاتهای با Latency بالا
- 65. بررسی میزان استفاده از GPU (GPU Utilization)
- 66. تحلیل پهنای باند حافظه و ترافیک داده
- 67. شناسایی Bottleneckهای ناشی از Warp Divergence و Bank Conflict
- 68. استفاده از ابزارهای پروفایلینگ فریمورکها (e.g., PyTorch Profiler, TensorFlow Profiler)
- 69. تجزیه و تحلیل ردیابی (Trace Analysis) برای درک جریان اجرایی
- 70. تکنیکهای بنچمارکینگ (Benchmarking) دقیق و قابل تکرار
- 71. آموزش با دقت مخلوط (Mixed Precision Training) با FP16 و BFloat16
- 72. استفاده از Automatic Mixed Precision (AMP) در PyTorch و TensorFlow
- 73. مزایا و چالشهای Mixed Precision
- 74. مفهوم Loss Scaling در Mixed Precision
- 75. بهینهسازی حجم بچ (Batch Size) برای GPU
- 76. تجمع گرادیان (Gradient Accumulation) برای شبیهسازی بچهای بزرگتر
- 77. بارگذاری داده پویا (Dynamic Batching) برای افزایش استفاده از GPU
- 78. تاثیر بهینهسازها (Optimizers) و زمانبند نرخ یادگیری (Learning Rate Schedulers) بر سرعت همگرایی
- 79. استفاده از Dataloaders با قابلیت پیشواکشی (Prefetching)
- 80. تکنیکهای کاهش مصرف حافظه در آموزش (e.g., Gradient Checkpointing)
- 81. مقدمهای بر آموزش توزیعشده (Distributed Training)
- 82. Data Parallelism: روش اصلی آموزش بر روی چند GPU
- 83. مفهوم All-Reduce و نقش آن در Data Parallelism
- 84. پیادهسازی DistributedDataParallel در PyTorch
- 85. پیادهسازی MirroredStrategy/MultiWorkerMirroredStrategy در TensorFlow
- 86. Pipe-line Parallelism برای مدلهای بزرگ
- 87. Tensor Parallelism برای لایههای بزرگ
- 88. ترکیب Data و Model Parallelism
- 89. ارتباطات بین GPUها (NVLink, PCIe)
- 90. بهینهسازی ارتباطات شبکه برای Multi-GPU Training
- 91. بهینهسازی استنتاج (Inference Optimization)
- 92. کوانتیزاسیون (Quantization) مدل برای کاهش حجم و افزایش سرعت
- 93. کوانتیزاسیون پس از آموزش (Post-Training Quantization - PTQ)
- 94. کوانتیزاسیون در حین آموزش (Quantization-Aware Training - QAT)
- 95. معرفی NVIDIA TensorRT برای بهینهسازی استنتاج
- 96. استفاده از ONNX و ONNX Runtime برای استنتاج Cross-Platform
- 97. کامپایلرهای JIT (Just-In-Time) مانند TorchScript و XLA
- 98. Fusion کرنل و Graph Optimization برای افزایش کارایی
- 99. استراتژیهای سرو مدلهای DL (Model Serving) با تاخیر کم و throughput بالا
- 100. ملاحظات اخلاقی و پایداری در محاسبات با کارایی بالا (High-Performance Computing)
SMART LEARNING PLATFORM
از مطالعه تا یادگیری ماندگار
فراتر از یک مجموعه فلشکارت؛ تجربهای تعاملی برای یادگیری، تمرین، مرور هوشمند و مشاهده مسیر پیشرفت شما، همراه با امکان دریافت گواهی پایان دوره در دورههای واجد شرایط.
مرور فاصلهدار
آمار یادگیری
گواهی دوزبانه
یادگیری را به یک مسیر قابل پیگیری تبدیل کنید
با ورود به سامانه آموزشی، محتوای دوره را بهصورت مرحلهای دنبال کنید، فلشکارتها را مرور کنید، دانش خود را با پرسشها و آزمونها بسنجید و روند پیشرفتتان را در طول مسیر ببینید.
⟳
مرور فاصلهدار هوشمند
با مرور زماندار، کارتهای تازه و کارتهای سررسیدشده را بر اساس برنامه مرور دنبال کنید. ارزیابی پاسخها به زمانبندی مرورهای بعدی کمک میکند تا تمرین متناسبتری داشته باشید.
◉
مشاهده مسیر پیشرفت
میزان مشاهده فلشکارتها، فعالیتهای مرور، عملکرد آزمونها و آمار یادگیری را بررسی کنید و تصویر روشنتری از مسیر آموزشی خود داشته باشید.
▤
یادگیری مرحلهبهمرحله
فصلها و بخشهای آموزشی را به ترتیب دنبال کنید، مطالب دیدهنشده را پیدا کنید و بدون سردرگمی به ادامه مسیر برگردید.
✓
تمرین و سنجش آموختهها
با نکتههای آموزشی، پرسش و پاسخ، کوییزها و آزمونهای پایان فصل، دانستههای خود را تمرین کنید و بخشهایی را که به توجه بیشتری نیاز دارند بشناسید.
SMART REVIEW
هر بار، مرور هدفمندتر
لازم نیست هر روز از ابتدا درباره اینکه چه چیزی را مرور کنید تصمیم بگیرید. سامانه، صف مرور روزانه را بر اساس کارتهای تازه و موعد مرور کارتها آماده میکند. شما پاسخ را ارزیابی میکنید و برنامه مرور با توجه به آن تنظیم میشود.
دوباره
برای کارتهایی که به تمرین زودتر نیاز دارند.
سخت
برای پاسخهایی که با دشواری به یاد آمدهاند.
خوب
برای پاسخهایی که بهدرستی به یاد آوردهاید.
آسان
برای کارتهایی که پاسخ آنها را بهآسانی میدانید.
برنامه مرور بر اساس ارزیابی شما تنظیم میشود؛ مرور منظم میتواند به تثبیت آموختهها کمک کند، اما بهتنهایی تضمینکننده تسلط کامل نیست.
محتوا را به شیوههای مختلف تمرین کنید
ساختار دورهها متناسب با موضوع آموزشی طراحی شده است و ممکن است انواع مختلفی از محتوا را در بر بگیرد.
نکتههای ساده
برای مرور سریع مفاهیم اصلی و نکات کلیدی.
نکتههای رسمی
برای تمرین تعاریف، اصطلاحات و بیان دقیق علمی.
کوییز
برای سنجش درک مطلب و بررسی گزینه صحیح.
پرسش و پاسخ
برای تمرین یادآوری و سنجش میزان تسلط بر مطالب.
محتوای هر دوره بر اساس ساختار و امکانات فعال همان دوره ارائه میشود.
LEARN ANYWHERE
همراه شما روی مرورگر
برای استفاده از نسخه تحت وب، کافی است با حساب کاربری خود وارد سامانه شوید. بدون نیاز به نصب یک برنامه اختصاصی، میتوانید از مرورگر سازگار روی گوشی، تبلت یا رایانه به دورههای در دسترس خود مراجعه کنید.
گوشی هوشمند
برای مطالعه در زمانهای کوتاه
تبلت و لپتاپ
برای مطالعه و مرور راحتتر
حساب کاربری شخصی
برای دسترسی به دورههای مجاز شما
COURSE COMPLETION CERTIFICATE
گواهی پایان دوره؛ ثبت دستاورد شما
در دورههایی که امکان دریافت گواهی برای آنها فعال است، میتوانید پس از تکمیل شرایط آموزشی، درخواست گواهی پایان دوره ثبت کنید.
شرایط درخواست گواهی
✓ داشتن دسترسی دارای قابلیت گواهی برای دوره مربوطه.
✓ تکمیل اطلاعات لازم در پروفایل، شامل کد ملی معتبر، عکس پرسنلی و نام و نام خانوادگی انگلیسی.
✓ مشاهده تمام فلشکارتهای فعال دوره.
✓ قبولی در آزمونهای پایان فصل، در صورت وجود آزمون برای فصلها.
فارسی و انگلیسی
پس از تأیید و انتشار، نسخههای فارسی و انگلیسی گواهی در دسترس قرار میگیرند.
استعلام آنلاین
گواهی منتشرشده دارای QR Code و لینک اختصاصی برای بررسی آنلاین اعتبار آن است.
دانلود و چاپ
پس از انتشار گواهی، امکان دریافت نسخه PDF فارسی و انگلیسی و چاپ آن فراهم است.
توجه: ثبت درخواست به معنای صدور قطعی نیست. درخواست گواهی پس از بررسی و تأیید ادمین منتشر میشود. این گواهی، گواهی پایان دوره آموزشی است و بهخودیخود معادل مدرک دانشگاهی یا مدرک رسمی مورد تأیید نهادهای دولتی نیست.
یادگیری را شروع کنید؛ پیشرفت را دنبال کنید
با تمرین منظم، مرور هدفمند و پیگیری مسیر آموزشی خود، قدمبهقدم دانش و مهارتهایتان را گسترش دهید.
هر کارت، یک قدم به جلو
امکانات محتوایی، مرور و گواهی بر اساس سطح دسترسی و تنظیمات هر دوره متفاوت است.
نگاهی به محیط سامانه
یادگیری هوشمند، قدمبهقدم
با محیط سامانه آموزشی آشنا شوید و نمونههایی از فضای یادگیری، فلشکارتها و ابزارهای مرور و تمرین را مشاهده کنید.
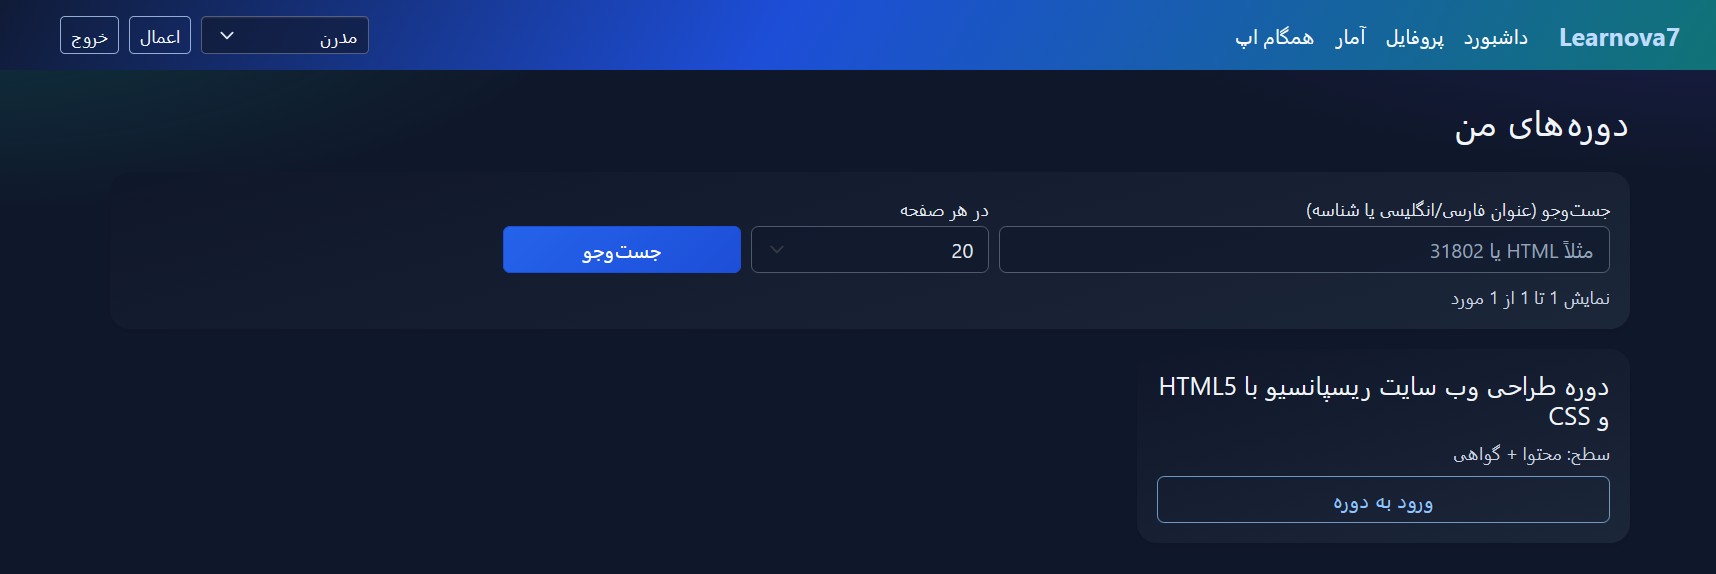
محیط سامانه آموزشی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
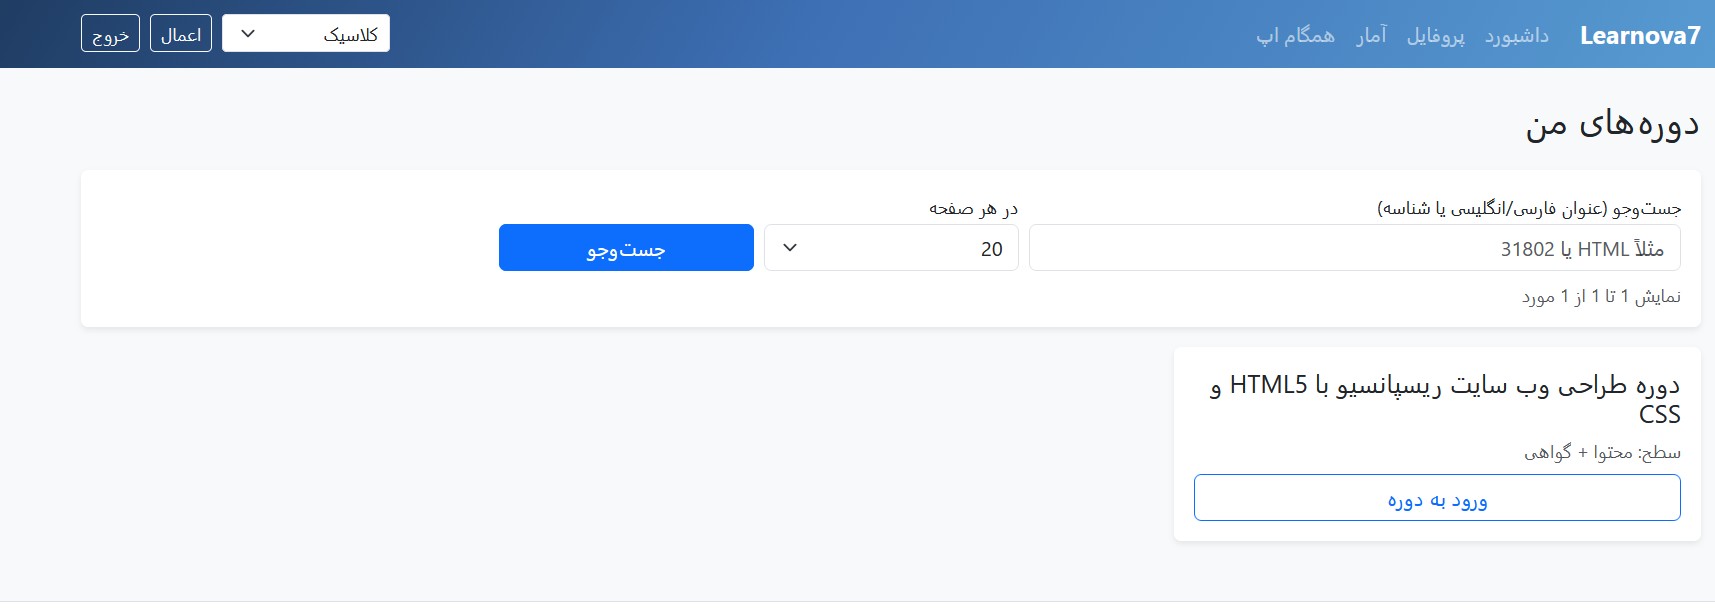
یادگیری و مرور مطالب
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
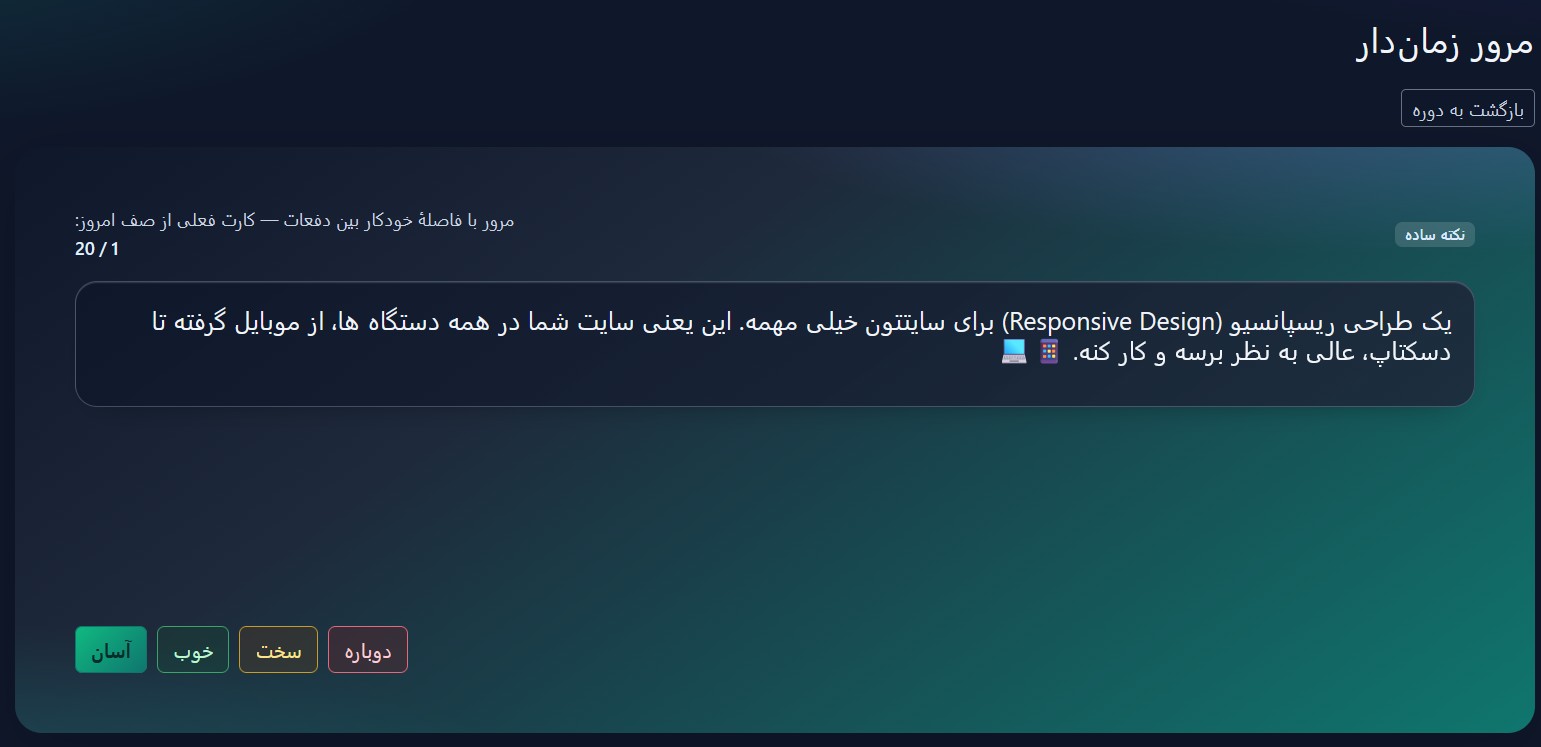
تجربه مطالعه تعاملی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
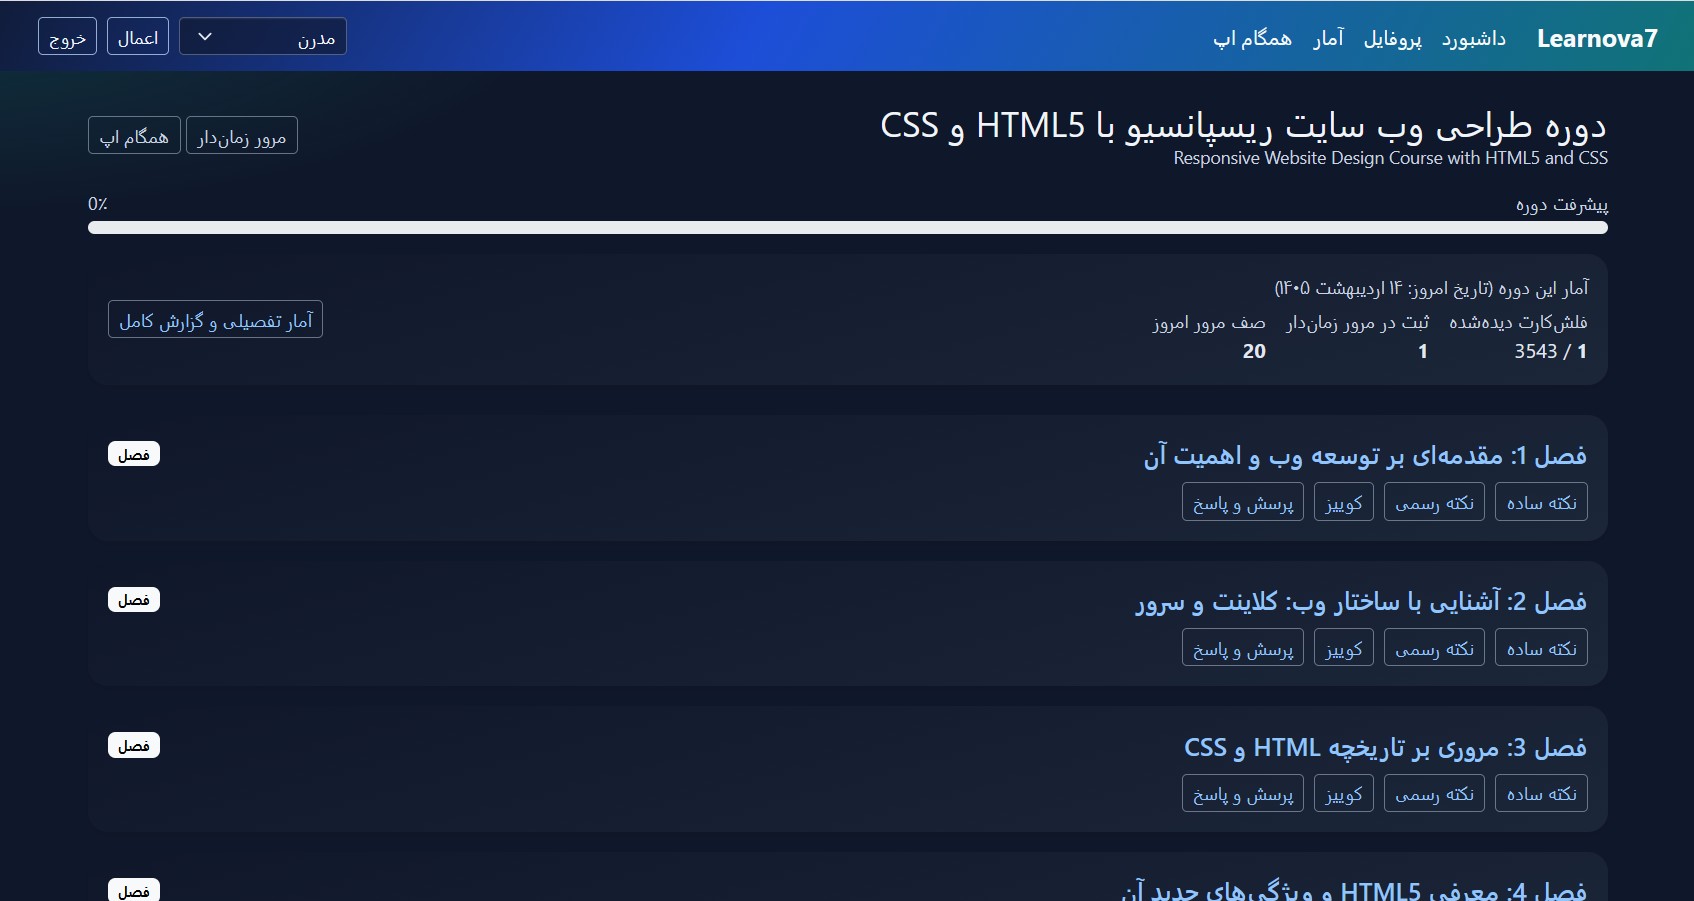
امکانات بیشتر سامانه
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
یادگیری فراتر از مطالعه معمولی
با فلشکارتهای آموزشی، مرور هدفمند و تمرین مستمر، مطالب را فعالانه یاد بگیرید و مسیر پیشرفت خود را دنبال کنید.
تگها:
CUDA
DL Optimization
GPU Programming
High-Performance Computing
PyTorch
TensorFlow
آموزش GPU
آموزش برنامه نویسی
برنامه نویسی GPU
برنامه نویسی موازی
بهینه سازی DL GPU
بهینه سازی مدل های DL
عملکرد GPU
محاسبات سطح بالا
یادگیری عمیق GPU
نظرات
هنوز نظری ثبت نشده است.
وارد شوید تا نظر ثبت کنید.