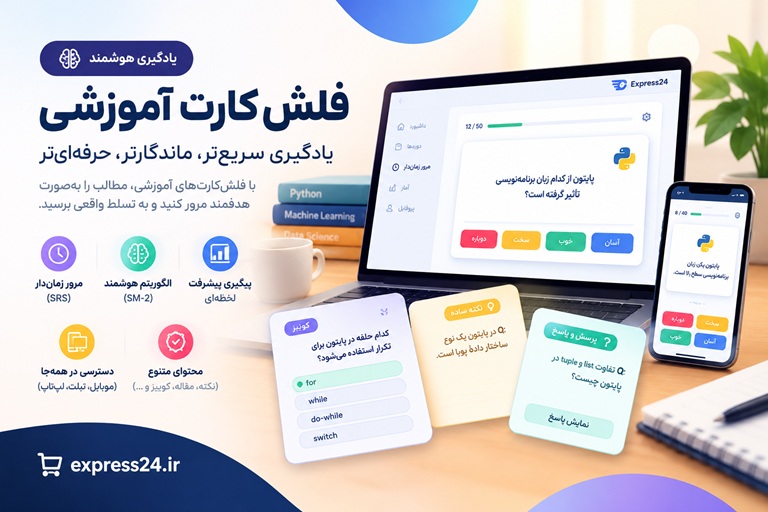
فلشکارتهای آموزشی بهینهسازی برای پردازندههای گرافیکی (GPU)
دوره جامع بهینهسازی برای پردازندههای گرافیکی (GPU) قدرت پنهان GPU را آزاد کنید: دوره جامع بهینهسازی برای پردازندههای گرافیکی معرفی دوره: انقلابی در سرعت محاسبات شما آیا تا به حال با کدی روبرو شده...
🎓 دوره آموزشی جامع
📚 اطلاعات دوره
عنوان دوره: دوره بهینهسازی برای پردازندههای گرافیکی (GPU)
موضوع کلی: برنامه نویسی
موضوع میانی: محاسبات سطح بالا (High-Performance Computing)
📋 سرفصلهای دوره
- 1. مقدمهای بر محاسبات با کارایی بالا (HPC)
- 2. مفاهیم اساسی پردازش موازی
- 3. معماری پردازندههای مرکزی (CPU) و محدودیتها
- 4. معرفی پردازندههای گرافیکی (GPU) و تکامل آنها
- 5. تفاوتهای معماری CPU و GPU
- 6. مزایای استفاده از GPU در محاسبات علمی
- 7. مدلهای برنامهنویسی موازی برای GPU (مثل CUDA و OpenCL)
- 8. انتخاب پلتفرم برنامهنویسی GPU (CUDA در مقابل OpenCL)
- 9. نصب و راهاندازی محیط توسعه CUDA
- 10. اولین برنامه GPU: Hello World
- 11. ساختار یک برنامه CUDA
- 12. توابع هسته (Kernel Functions)
- 13. مفاهیم Thread، Block و Grid
- 14. ابعاددهی Grid و Block
- 15. مدیریت حافظه در CUDA: Host و Device
- 16. انتقال داده بین Host و Device
- 17. توابع CudaMemcpy و CudaMalloc
- 18. مدیریت خطا در برنامههای CUDA
- 19. مثال عملی: جمع دو بردار در GPU
- 20. زمانبندی و اندازهگیری عملکرد ابتدایی
- 21. متغیرهای Built-in در CUDA (threadIdx, blockIdx, blockDim, gridDim)
- 22. اجرای همزمان هستهها (Concurrent Kernel Execution)
- 23. آشنایی با Streamها برای اجرای موازیتر
- 24. مدیریت رویدادها (Events) برای همگامسازی
- 25. مقدمهای بر مدل اجرای ناهمزمان (Asynchronous Execution)
- 26. سلسله مراتب حافظه در GPU (Global, Shared, Local, Constant, Texture)
- 27. حافظه جهانی (Global Memory) و ویژگیهای آن
- 28. بهینهسازی دسترسی به حافظه جهانی: Coalescing
- 29. مثال عملی: پیادهسازی Coalescing در جمع بردار
- 30. حافظه مشترک (Shared Memory) و کاربردهای آن
- 31. بانکهای حافظه مشترک (Shared Memory Banks) و تضاد (Bank Conflicts)
- 32. بهینهسازی با استفاده از Shared Memory برای ماتریس ضرب
- 33. Padding در Shared Memory برای جلوگیری از Bank Conflicts
- 34. حافظه محلی (Local Memory) و زمانبندی رجیسترها
- 35. حافظه ثابت (Constant Memory) و کش آن
- 36. کاربرد حافظه ثابت برای دادههای فقط خواندنی
- 37. حافظه بافت (Texture Memory) برای دسترسیهای دوبعدی
- 38. حافظه یکپارچه (Unified Memory) و مزایای آن
- 39. حافظه Pin-locked (Page-locked) و افزایش سرعت انتقال
- 40. مدیریت حافظه بهینه در برنامههای پیچیده
- 41. مفاهیم عملکرد GPU: توان عملیاتی (Throughput) و تاخیر (Latency)
- 42. اهمیت پهنای باند حافظه و قدرت محاسباتی
- 43. مدل سقف عملکرد (Roofline Model) برای GPU: مفاهیم پایه
- 44. ابزارهای پروفایلینگ NVIDIA (NVIDIA Nsight Systems, Nsight Compute)
- 45. Nsight Systems: تحلیل سیستم-سطح و ردیابی
- 46. Nsight Compute: تحلیل هسته-سطح و متریکها
- 47. متریکهای کلیدی عملکرد: Occupancy، پهنای باند حافظه، دستورالعمل در ساعت
- 48. شناسایی گلوگاههای عملکردی (Bottlenecks)
- 49. تحلیل استفاده از رجیسترها و سرریز (Register Spill)
- 50. درک و تفسیر نمودارهای پروفایلر
- 51. تحلیل Dependency و Latency در هستهها
- 52. پیگیری استفاده از زمانبندی (Scheduler) و Dispatch
- 53. جمعآوری دادههای عملکرد در زمان اجرا
- 54. اندازهگیری دقیق زمان با CUDA Events
- 55. بررسی Overhead انتقال داده
- 56. کاهش واگرایی Thread (Thread Divergence) در بلوکها
- 57. استفاده بهینه از دستورالعملهای Warp-level (Shuffle, Vote)
- 58. تکنیکهای کاهش Global Memory Latency
- 59. بهینهسازی دسترسیهای غیرCoalesced
- 60. Loop Unrolling و تأثیر آن بر عملکرد
- 61. استفاده از توابع Intrinsic (Built-in) برای عملکرد بهتر
- 62. عملیات اتمی (Atomic Operations) و هزینه آنها
- 63. کاهش استفاده از عملیات اتمی و جایگزینها
- 64. پیادهسازی Reduction روی GPU بهینه
- 65. پیادهسازی Scan (Prefix Sum) روی GPU بهینه
- 66. بهینهسازی عملیات Filter و Map
- 67. Kernel Fusion برای کاهش Overhead راهاندازی هستهها
- 68. همپوشانی محاسبات و انتقال داده (Overlap Compute and Transfer)
- 69. استفاده از Zero-Copy Memory برای انتقال داده
- 70. بهینهسازی برای GPUهای مختلف (نسلهای مختلف معماری)
- 71. الگوهای طراحی موازی برای GPU (GPU Design Patterns)
- 72. الگوریتمهای مرتبسازی موازی (Sorting Algorithms on GPU)
- 73. پیادهسازی Bucketsort و Radix Sort روی GPU
- 74. الگوریتمهای جستجو و درختها در GPU
- 75. تبدیل فوریه سریع (FFT) روی GPU با cuFFT
- 76. ضرب ماتریس پیشرفته (GEMM) با cuBLAS
- 77. حل سیستمهای خطی با cuSOLVER
- 78. کتابخانه Thrust برای ساختارهای داده و الگوریتمهای موازی
- 79. استفاده از Thrust برای سادهسازی کد GPU
- 80. معرفی کتابخانه cuDNN برای یادگیری عمیق
- 81. الگوریتمهای گراف و شبکهها روی GPU
- 82. رندرینگ گرافیکی پیشرفته با GPU (Ray Tracing Basics)
- 83. شبیهسازی فیزیکی و CFD روی GPU
- 84. کاربردهای GPU در تحلیل دادههای بزرگ (Big Data Analytics)
- 85. بهینهسازی برای کاربردهای یادگیری ماشینی و هوش مصنوعی
- 86. برنامهنویسی چند GPU (Multi-GPU Programming)
- 87. P2P Communication (Peer-to-Peer) برای سرعت بخشیدن به انتقال داده بین GPUها
- 88. NVLink و NVSwitch برای ارتباطات فوق سریع
- 89. Data Parallelism و Task Parallelism در محیط چند GPU
- 90. هماهنگی CPU و GPU در یک سیستم ناهمگون
- 91. تعامل CUDA با APIهای گرافیکی (OpenGL, DirectX)
- 92. Dynamic Parallelism: هستههایی که هستههای دیگر را راهاندازی میکنند
- 93. مجازیسازی GPU و کاربردهای آن
- 94. بررسی تاثیر مصرف انرژی بر عملکرد (Power Efficiency)
- 95. مقایسه GPU با FPGA و سایر شتابدهندهها
- 96. معماریهای جدید GPU و ویژگیهای آنها (مثلاً Hopper, Blackwell)
- 97. برنامهنویسی GPU در زبانهای سطح بالا (Julia, Python با Numba)
- 98. استفاده از OpenACC و OpenMP برای بارگذاری خودکار روی GPU
- 99. بهینهسازی خودکار و Autotuning برای GPU
- 100. چالشها و روندهای آینده در محاسبات با GPU
SMART LEARNING PLATFORM
از مطالعه تا یادگیری ماندگار
فراتر از یک مجموعه فلشکارت؛ تجربهای تعاملی برای یادگیری، تمرین، مرور هوشمند و مشاهده مسیر پیشرفت شما، همراه با امکان دریافت گواهی پایان دوره در دورههای واجد شرایط.
مرور فاصلهدار
آمار یادگیری
گواهی دوزبانه
یادگیری را به یک مسیر قابل پیگیری تبدیل کنید
با ورود به سامانه آموزشی، محتوای دوره را بهصورت مرحلهای دنبال کنید، فلشکارتها را مرور کنید، دانش خود را با پرسشها و آزمونها بسنجید و روند پیشرفتتان را در طول مسیر ببینید.
⟳
مرور فاصلهدار هوشمند
با مرور زماندار، کارتهای تازه و کارتهای سررسیدشده را بر اساس برنامه مرور دنبال کنید. ارزیابی پاسخها به زمانبندی مرورهای بعدی کمک میکند تا تمرین متناسبتری داشته باشید.
◉
مشاهده مسیر پیشرفت
میزان مشاهده فلشکارتها، فعالیتهای مرور، عملکرد آزمونها و آمار یادگیری را بررسی کنید و تصویر روشنتری از مسیر آموزشی خود داشته باشید.
▤
یادگیری مرحلهبهمرحله
فصلها و بخشهای آموزشی را به ترتیب دنبال کنید، مطالب دیدهنشده را پیدا کنید و بدون سردرگمی به ادامه مسیر برگردید.
✓
تمرین و سنجش آموختهها
با نکتههای آموزشی، پرسش و پاسخ، کوییزها و آزمونهای پایان فصل، دانستههای خود را تمرین کنید و بخشهایی را که به توجه بیشتری نیاز دارند بشناسید.
SMART REVIEW
هر بار، مرور هدفمندتر
لازم نیست هر روز از ابتدا درباره اینکه چه چیزی را مرور کنید تصمیم بگیرید. سامانه، صف مرور روزانه را بر اساس کارتهای تازه و موعد مرور کارتها آماده میکند. شما پاسخ را ارزیابی میکنید و برنامه مرور با توجه به آن تنظیم میشود.
دوباره
برای کارتهایی که به تمرین زودتر نیاز دارند.
سخت
برای پاسخهایی که با دشواری به یاد آمدهاند.
خوب
برای پاسخهایی که بهدرستی به یاد آوردهاید.
آسان
برای کارتهایی که پاسخ آنها را بهآسانی میدانید.
برنامه مرور بر اساس ارزیابی شما تنظیم میشود؛ مرور منظم میتواند به تثبیت آموختهها کمک کند، اما بهتنهایی تضمینکننده تسلط کامل نیست.
محتوا را به شیوههای مختلف تمرین کنید
ساختار دورهها متناسب با موضوع آموزشی طراحی شده است و ممکن است انواع مختلفی از محتوا را در بر بگیرد.
نکتههای ساده
برای مرور سریع مفاهیم اصلی و نکات کلیدی.
نکتههای رسمی
برای تمرین تعاریف، اصطلاحات و بیان دقیق علمی.
کوییز
برای سنجش درک مطلب و بررسی گزینه صحیح.
پرسش و پاسخ
برای تمرین یادآوری و سنجش میزان تسلط بر مطالب.
محتوای هر دوره بر اساس ساختار و امکانات فعال همان دوره ارائه میشود.
LEARN ANYWHERE
همراه شما روی مرورگر
برای استفاده از نسخه تحت وب، کافی است با حساب کاربری خود وارد سامانه شوید. بدون نیاز به نصب یک برنامه اختصاصی، میتوانید از مرورگر سازگار روی گوشی، تبلت یا رایانه به دورههای در دسترس خود مراجعه کنید.
گوشی هوشمند
برای مطالعه در زمانهای کوتاه
تبلت و لپتاپ
برای مطالعه و مرور راحتتر
حساب کاربری شخصی
برای دسترسی به دورههای مجاز شما
COURSE COMPLETION CERTIFICATE
گواهی پایان دوره؛ ثبت دستاورد شما
در دورههایی که امکان دریافت گواهی برای آنها فعال است، میتوانید پس از تکمیل شرایط آموزشی، درخواست گواهی پایان دوره ثبت کنید.
شرایط درخواست گواهی
✓ داشتن دسترسی دارای قابلیت گواهی برای دوره مربوطه.
✓ تکمیل اطلاعات لازم در پروفایل، شامل کد ملی معتبر، عکس پرسنلی و نام و نام خانوادگی انگلیسی.
✓ مشاهده تمام فلشکارتهای فعال دوره.
✓ قبولی در آزمونهای پایان فصل، در صورت وجود آزمون برای فصلها.
فارسی و انگلیسی
پس از تأیید و انتشار، نسخههای فارسی و انگلیسی گواهی در دسترس قرار میگیرند.
استعلام آنلاین
گواهی منتشرشده دارای QR Code و لینک اختصاصی برای بررسی آنلاین اعتبار آن است.
دانلود و چاپ
پس از انتشار گواهی، امکان دریافت نسخه PDF فارسی و انگلیسی و چاپ آن فراهم است.
توجه: ثبت درخواست به معنای صدور قطعی نیست. درخواست گواهی پس از بررسی و تأیید ادمین منتشر میشود. این گواهی، گواهی پایان دوره آموزشی است و بهخودیخود معادل مدرک دانشگاهی یا مدرک رسمی مورد تأیید نهادهای دولتی نیست.
یادگیری را شروع کنید؛ پیشرفت را دنبال کنید
با تمرین منظم، مرور هدفمند و پیگیری مسیر آموزشی خود، قدمبهقدم دانش و مهارتهایتان را گسترش دهید.
هر کارت، یک قدم به جلو
امکانات محتوایی، مرور و گواهی بر اساس سطح دسترسی و تنظیمات هر دوره متفاوت است.
نگاهی به محیط سامانه
یادگیری هوشمند، قدمبهقدم
با محیط سامانه آموزشی آشنا شوید و نمونههایی از فضای یادگیری، فلشکارتها و ابزارهای مرور و تمرین را مشاهده کنید.
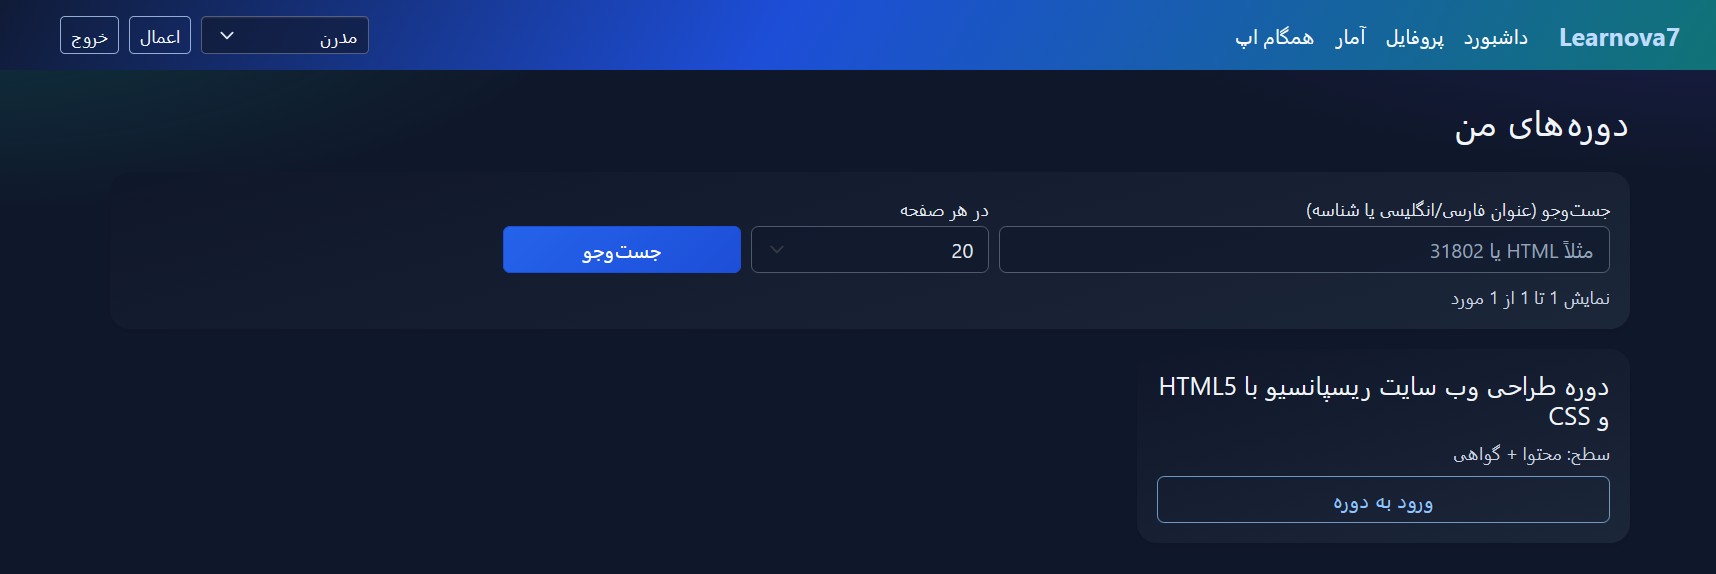
محیط سامانه آموزشی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
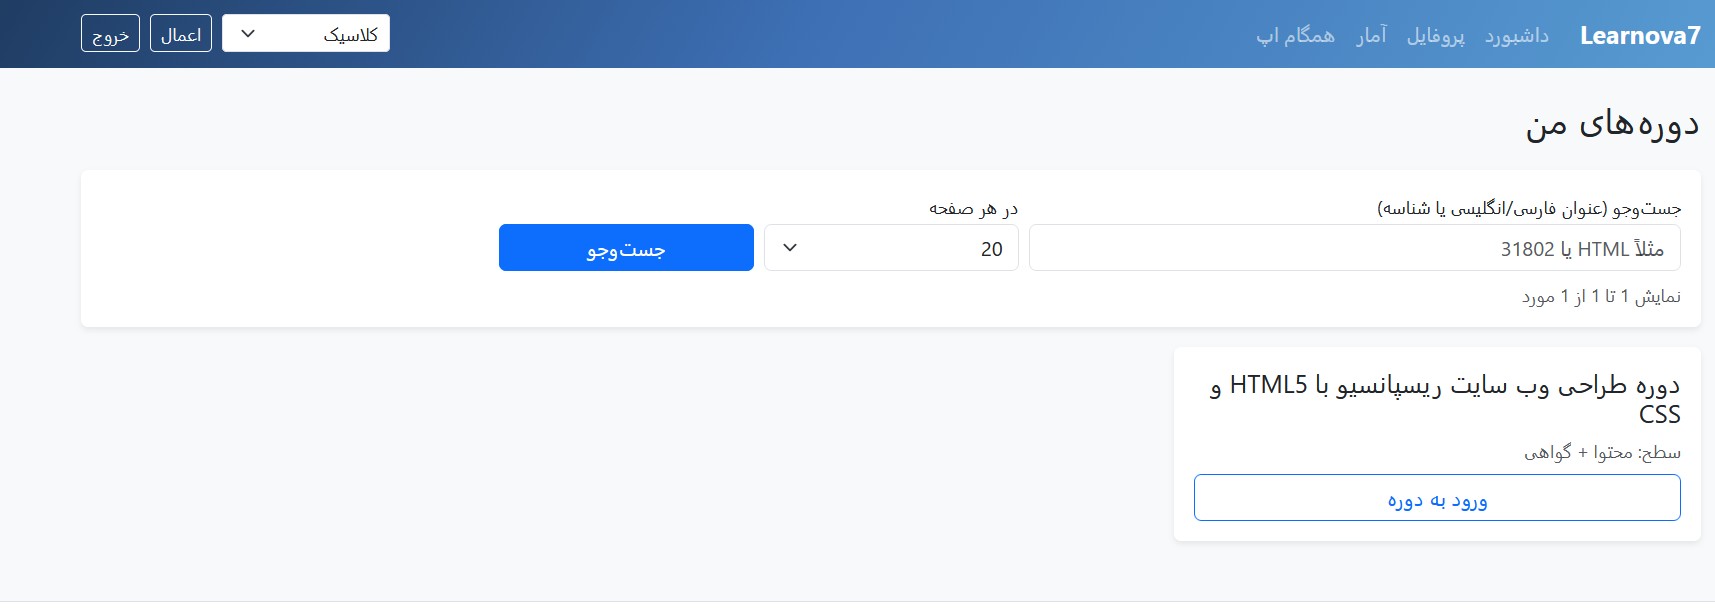
یادگیری و مرور مطالب
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
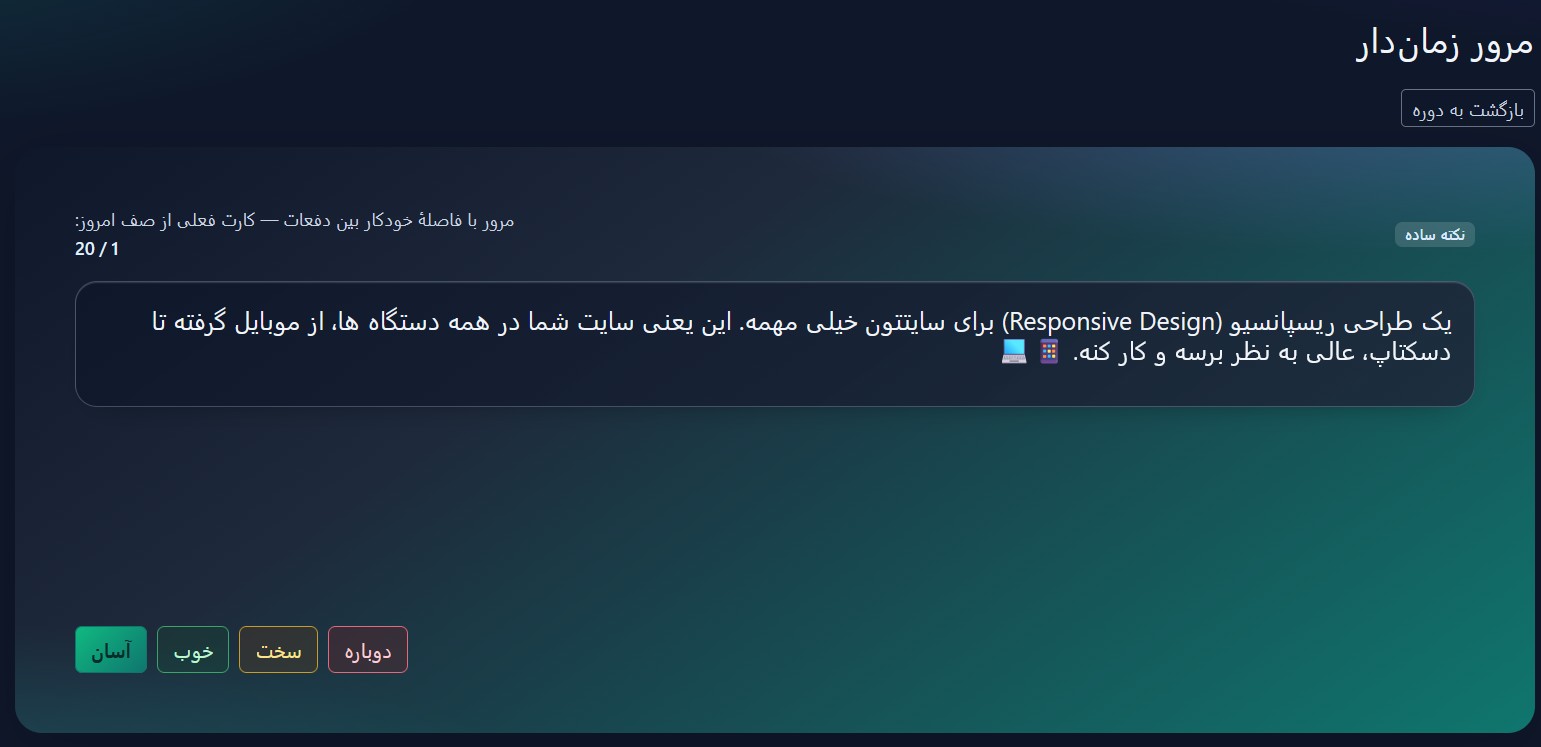
تجربه مطالعه تعاملی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
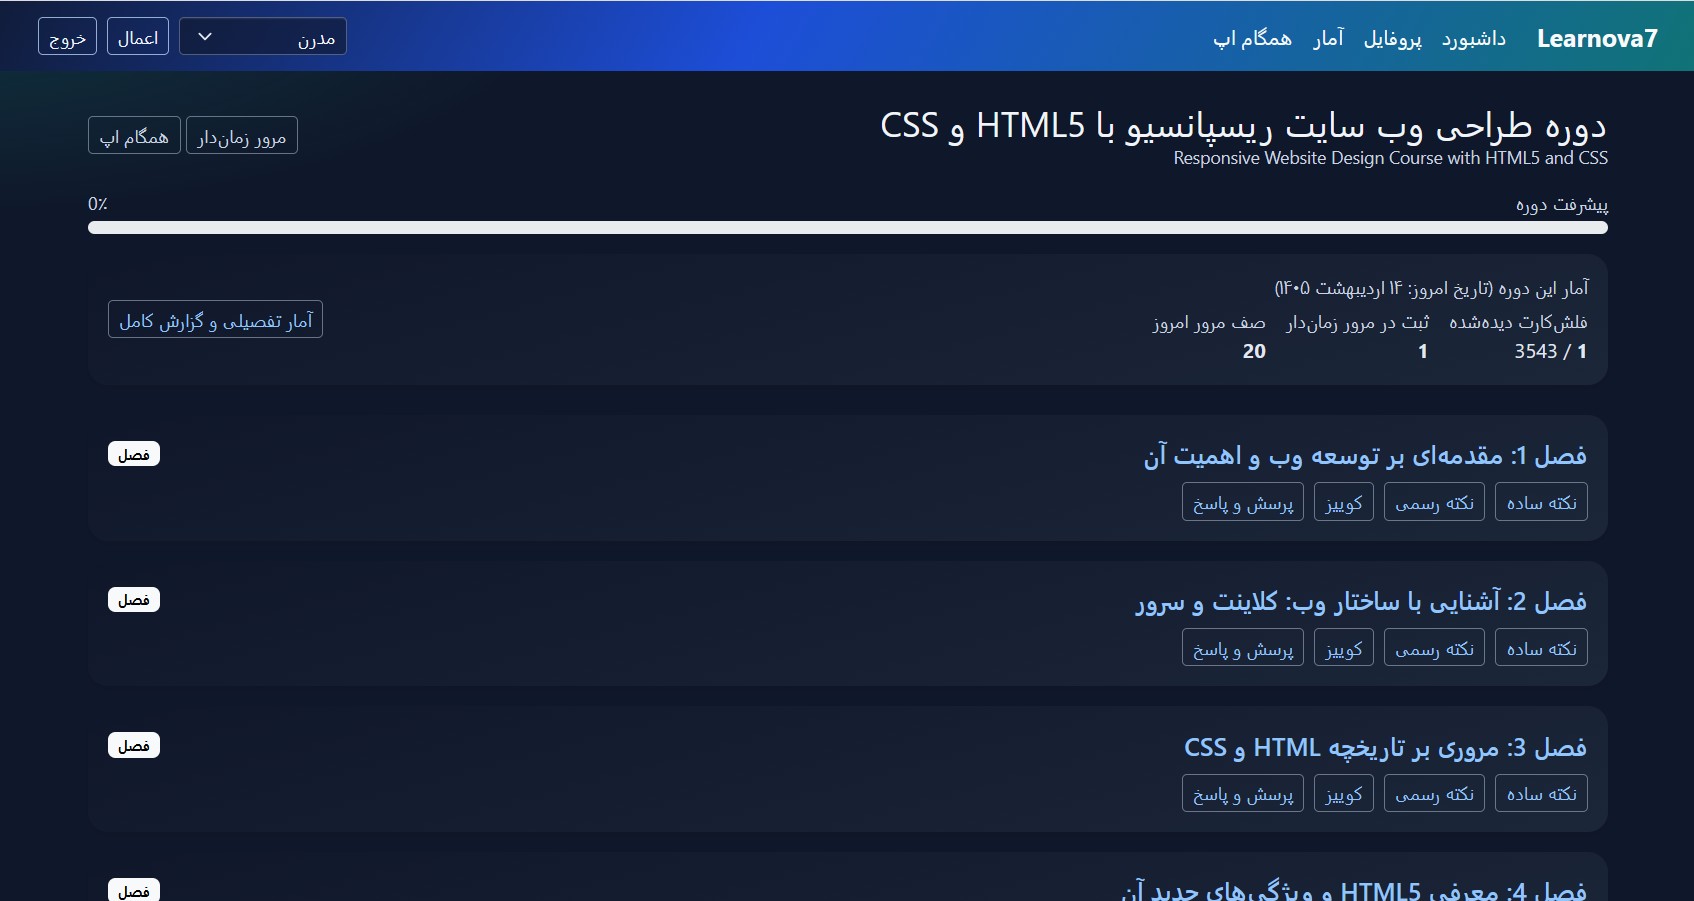
امکانات بیشتر سامانه
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
یادگیری فراتر از مطالعه معمولی
با فلشکارتهای آموزشی، مرور هدفمند و تمرین مستمر، مطالب را فعالانه یاد بگیرید و مسیر پیشرفت خود را دنبال کنید.
تگها:
CUDA
GPU
High-Performance Computing
HPC
OpenCL
آموزش GPU
آموزش برنامه نویسی
برنامه نویسی
برنامه نویسی GPU
برنامه نویسی موازی
بهینه سازی GPU
بهینه سازی پردازنده گرافیکی
عملکرد GPU
گرافیک
محاسبات سطح بالا
نظرات
هنوز نظری ثبت نشده است.
وارد شوید تا نظر ثبت کنید.